Indexierung erklärt
Der Seitenbericht in der GSC sortiert Ihre URLs in Gruppen mit Namen wie „Gecrawlt – zurzeit nicht indexiert“. Hier erfahren Sie, was jede davon bedeutet und welche Ihre Zeit wert sind.
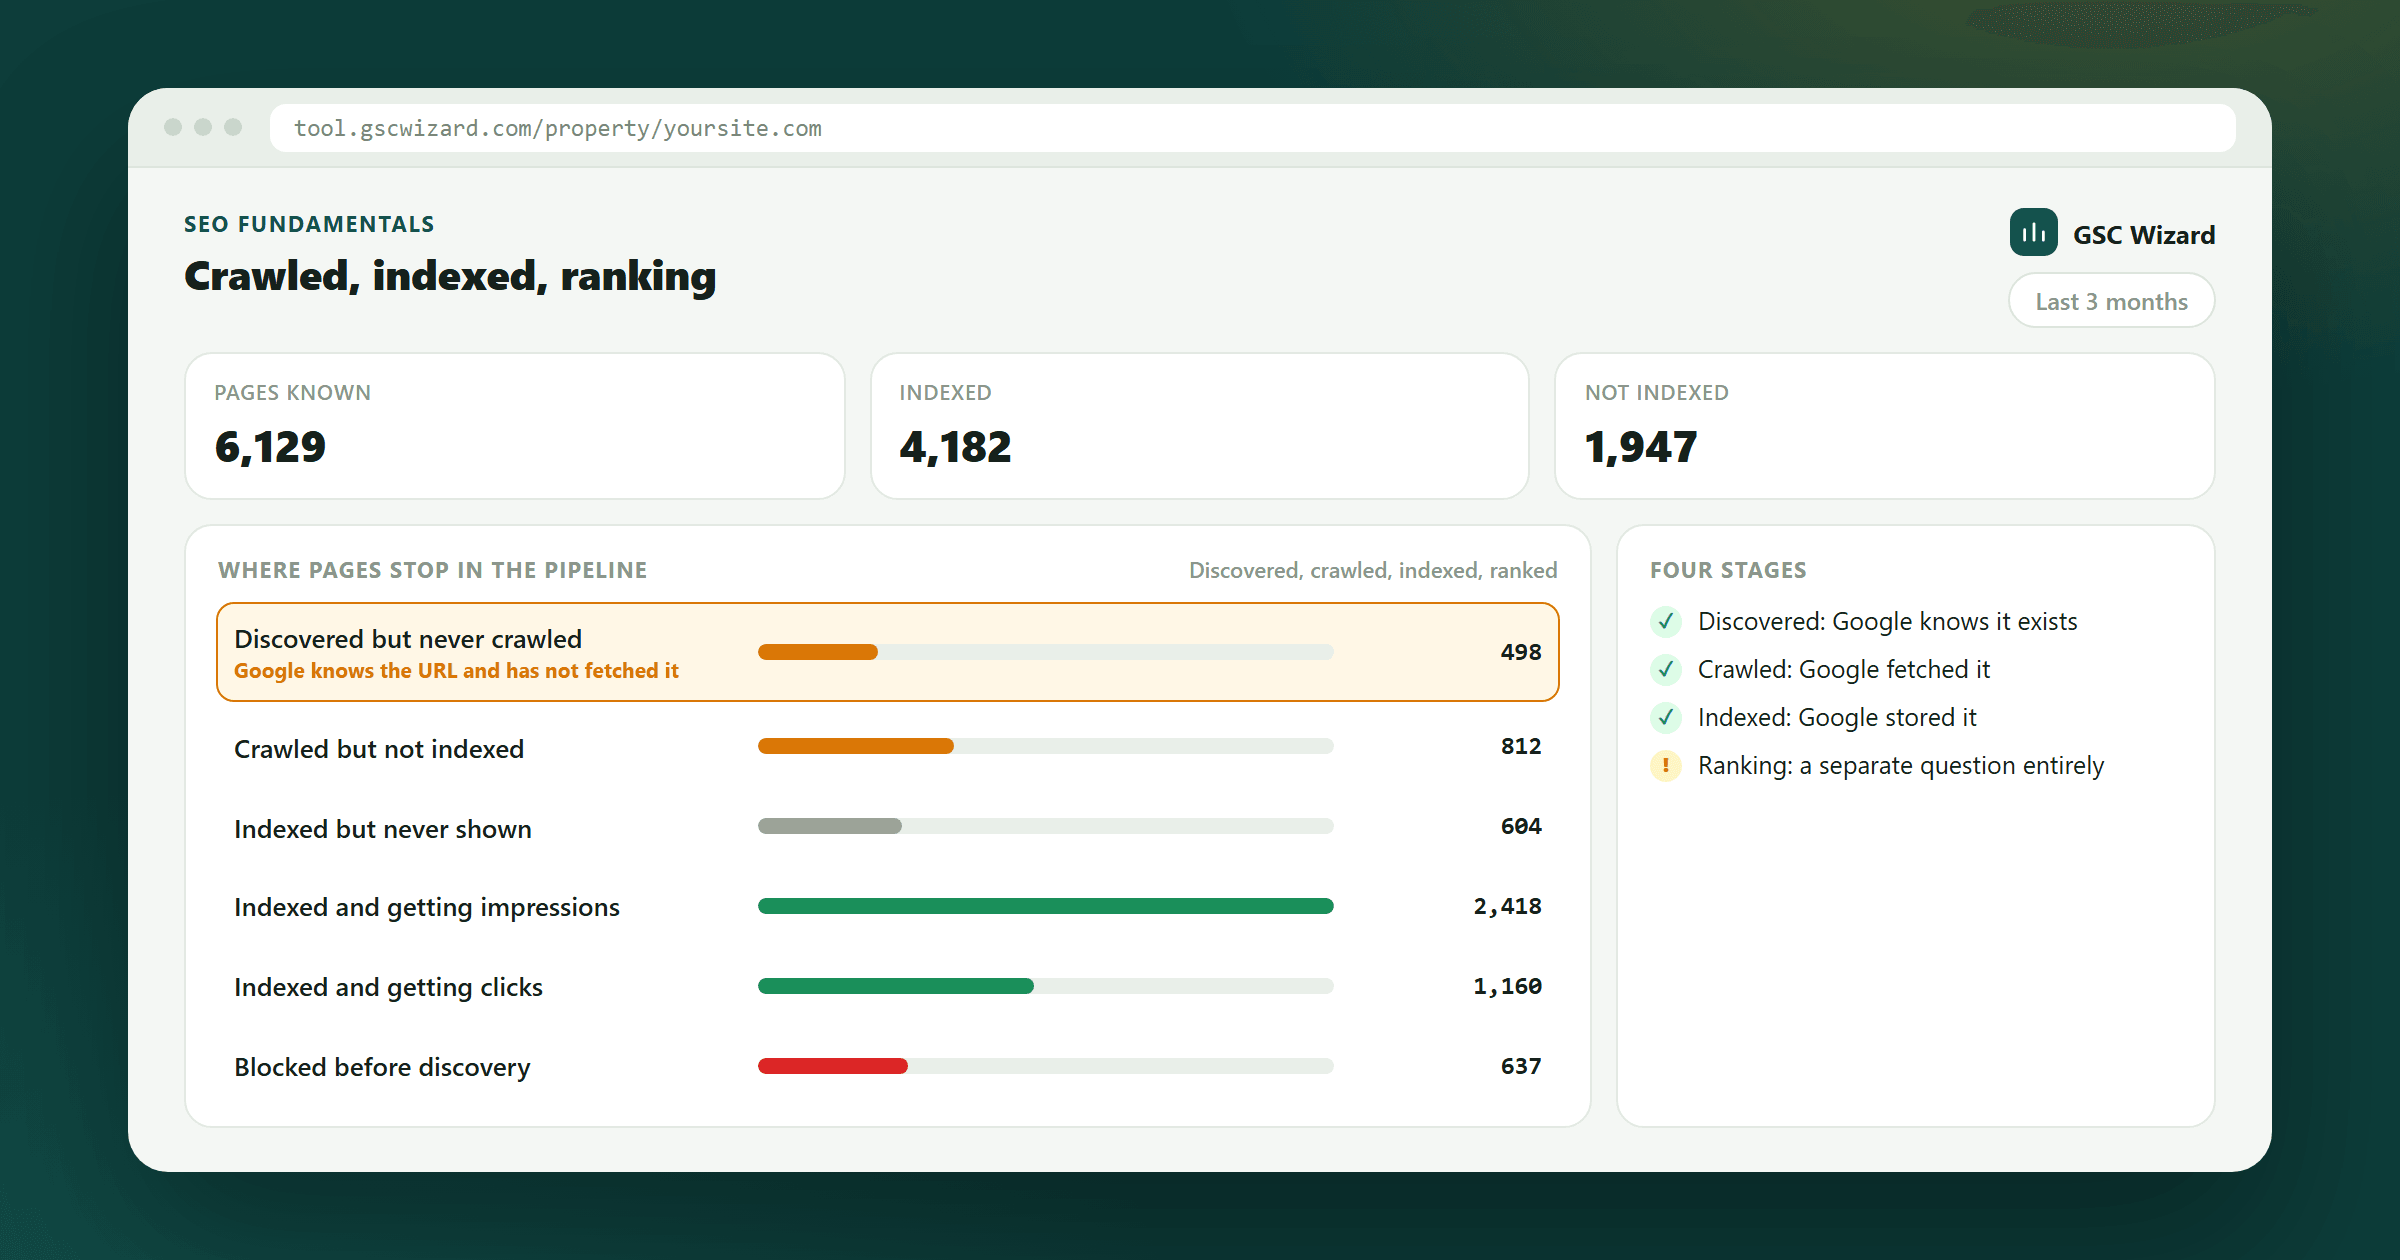
Der Lebenszyklus: gefunden → gecrawlt → indexiert
- Gefunden: Google kennt die URL (aus einer Sitemap, einem Link oder einem Ping), hat die Seite aber noch nicht heruntergeladen.
- Gecrawlt: Googlebot hat die Seite heruntergeladen.
- Indexiert: Google hat entschieden, dass die Seite es wert ist, in seiner durchsuchbaren Datenbank zu bleiben. Nur indexierte Seiten können ranken.
Ihr Ziel ist es, die Zahl der nützlichen URLs zu maximieren, die es bis zu „indexiert“ schaffen, und möglichst wenig Zeit damit zu verbringen, sich um wertlose URLs zu sorgen, die es nicht schaffen.
Die Status, die Sie sehen werden
Indexiert
Die Seite ist im Index von Google und kann in den Ergebnissen erscheinen. Genau das, was Sie wollen.
Gefunden – zurzeit nicht indexiert
Google weiß, dass die URL existiert, hat sie aber noch nicht einmal gecrawlt. Meist ein Zeichen dafür, dass Google Ihre Website das Crawl-Budget nicht wert findet. Siehe Gefunden – zurzeit nicht indexiert.
Gecrawlt – zurzeit nicht indexiert
Google hat die Seite gecrawlt, aber entschieden, dass sie die Indexierung nicht wert ist. Meist ein Qualitätssignal: Die Seite ist zu dünn, zu doppelt oder zu ähnlich zu Seiten, die schon im Index sind. Siehe Gecrawlt – zurzeit nicht indexiert.
Seite mit Weiterleitung
Die URL leitet auf eine andere Seite weiter. Meist unproblematisch, prüfen Sie aber, ob das Ziel indexiert ist. Siehe Seite mit Weiterleitung.
Soft 404
Die Seite liefert den Status 200 OK, wirkt für Google aber wie eine Fehler- oder leere Seite. Beheben Sie das, indem Sie die Seite entweder entfernen (echter 404) oder mit echtem Inhalt füllen. Siehe Soft 404 erklärt.
Duplikat: Google hat eine andere kanonische Seite gewählt
Sie haben Google mitgeteilt, dass URL A die kanonische ist, doch Google widerspricht und hat stattdessen URL B indexiert. Siehe Canonical-URLs in der GSC.
Durch noindex-Tag ausgeschlossen
Ihre Seite sagt „Indexiere mich nicht“. Wenn das Absicht ist (Admin-Seiten, Dankeseiten), ist alles gut. Steht der Noindex-Tag auf Seiten, die Sie eigentlich indexiert haben möchten, ist das der Fehler.
Welche sind wichtig?
In der Reihenfolge „lohnt sich, nachzuforschen“:
- „Durch Noindex-Tag ausgeschlossen“ bei Seiten, die indexiert sein sollten: sofort beheben.
- „Gecrawlt – zurzeit nicht indexiert“ bei Ihren Money Pages: meist ein Signal für die Content-Qualität.
- „Gefunden – zurzeit nicht indexiert“ in großem Umfang: ein Crawl-Budget-Problem, das sich oft durch bessere interne Verlinkung und das Aussortieren wertloser Seiten beheben lässt.
- Soft 404s bei Seiten, die Ihnen wichtig sind: Inhalt überarbeiten oder einen echten 404 ausgeben.
Im Zweifel nutzen Sie das URL-Prüftool für eine bestimmte URL, um die genaue Begründung von Google zu sehen.
Wie lange dauert die Indexierung?
Neue Inhalte können bei Websites mit hoher Autorität in Stunden indexiert werden, bei brandneuen Domains in Wochen. Wenn eine Seite seit mehr als 30 Tagen online und immer noch nicht indexiert ist, nutzen Sie Indexierung beantragen in der URL-Prüfung. Den ganzen Zusammenhang finden Sie unter Wie lange braucht Google, um eine Seite zu indexieren?
Überwachen, ohne ein Dashboard zu öffnen
Der Indexierungsstatus ändert sich unauffällig, weshalb man es meist spät bemerkt. Für getrackte URLs kann ein Alarm ausgelöst werden, wenn eine aus dem Index fällt oder nicht mehr gecrawlt wird, zugestellt an Slack oder Microsoft Teams.
Als Nächstes: Sie haben die Grundlagen abgeschlossen. Wechseln Sie zu den Playbooks und arbeiten Sie mit Ihren eigenen Daten.
Geschrieben von Jan-Willem Bobbink · Veröffentlicht am 19. April 2026 · Aktualisiert am 28. August 2026