Best Practices für SEO mit OpenClaw: 10 Regeln für den Betrieb von SEO-Agents
Mit OpenClaw ist es leicht, einem Agent Ihre Search Console, Ihre Analytics-Daten und Ihre SEO-Plattform zu geben, ihn nach Zeitplan laufen zu lassen und sich von ihm per Slack oder Telegram berichten zu lassen. Es ist aber ebenso leicht, das Skript eines Fremden mit Ihrem Google-Token zu füttern, an einem Wochenende ein Monatskontingent an API-Einheiten zu verbrennen oder nach einer Zahl zu handeln, die das Modell erfunden hat. Diese zehn Regeln decken die Fehler ab, die man am leichtesten macht. Bei den meisten geht es darum, was der Agent nicht tun darf.
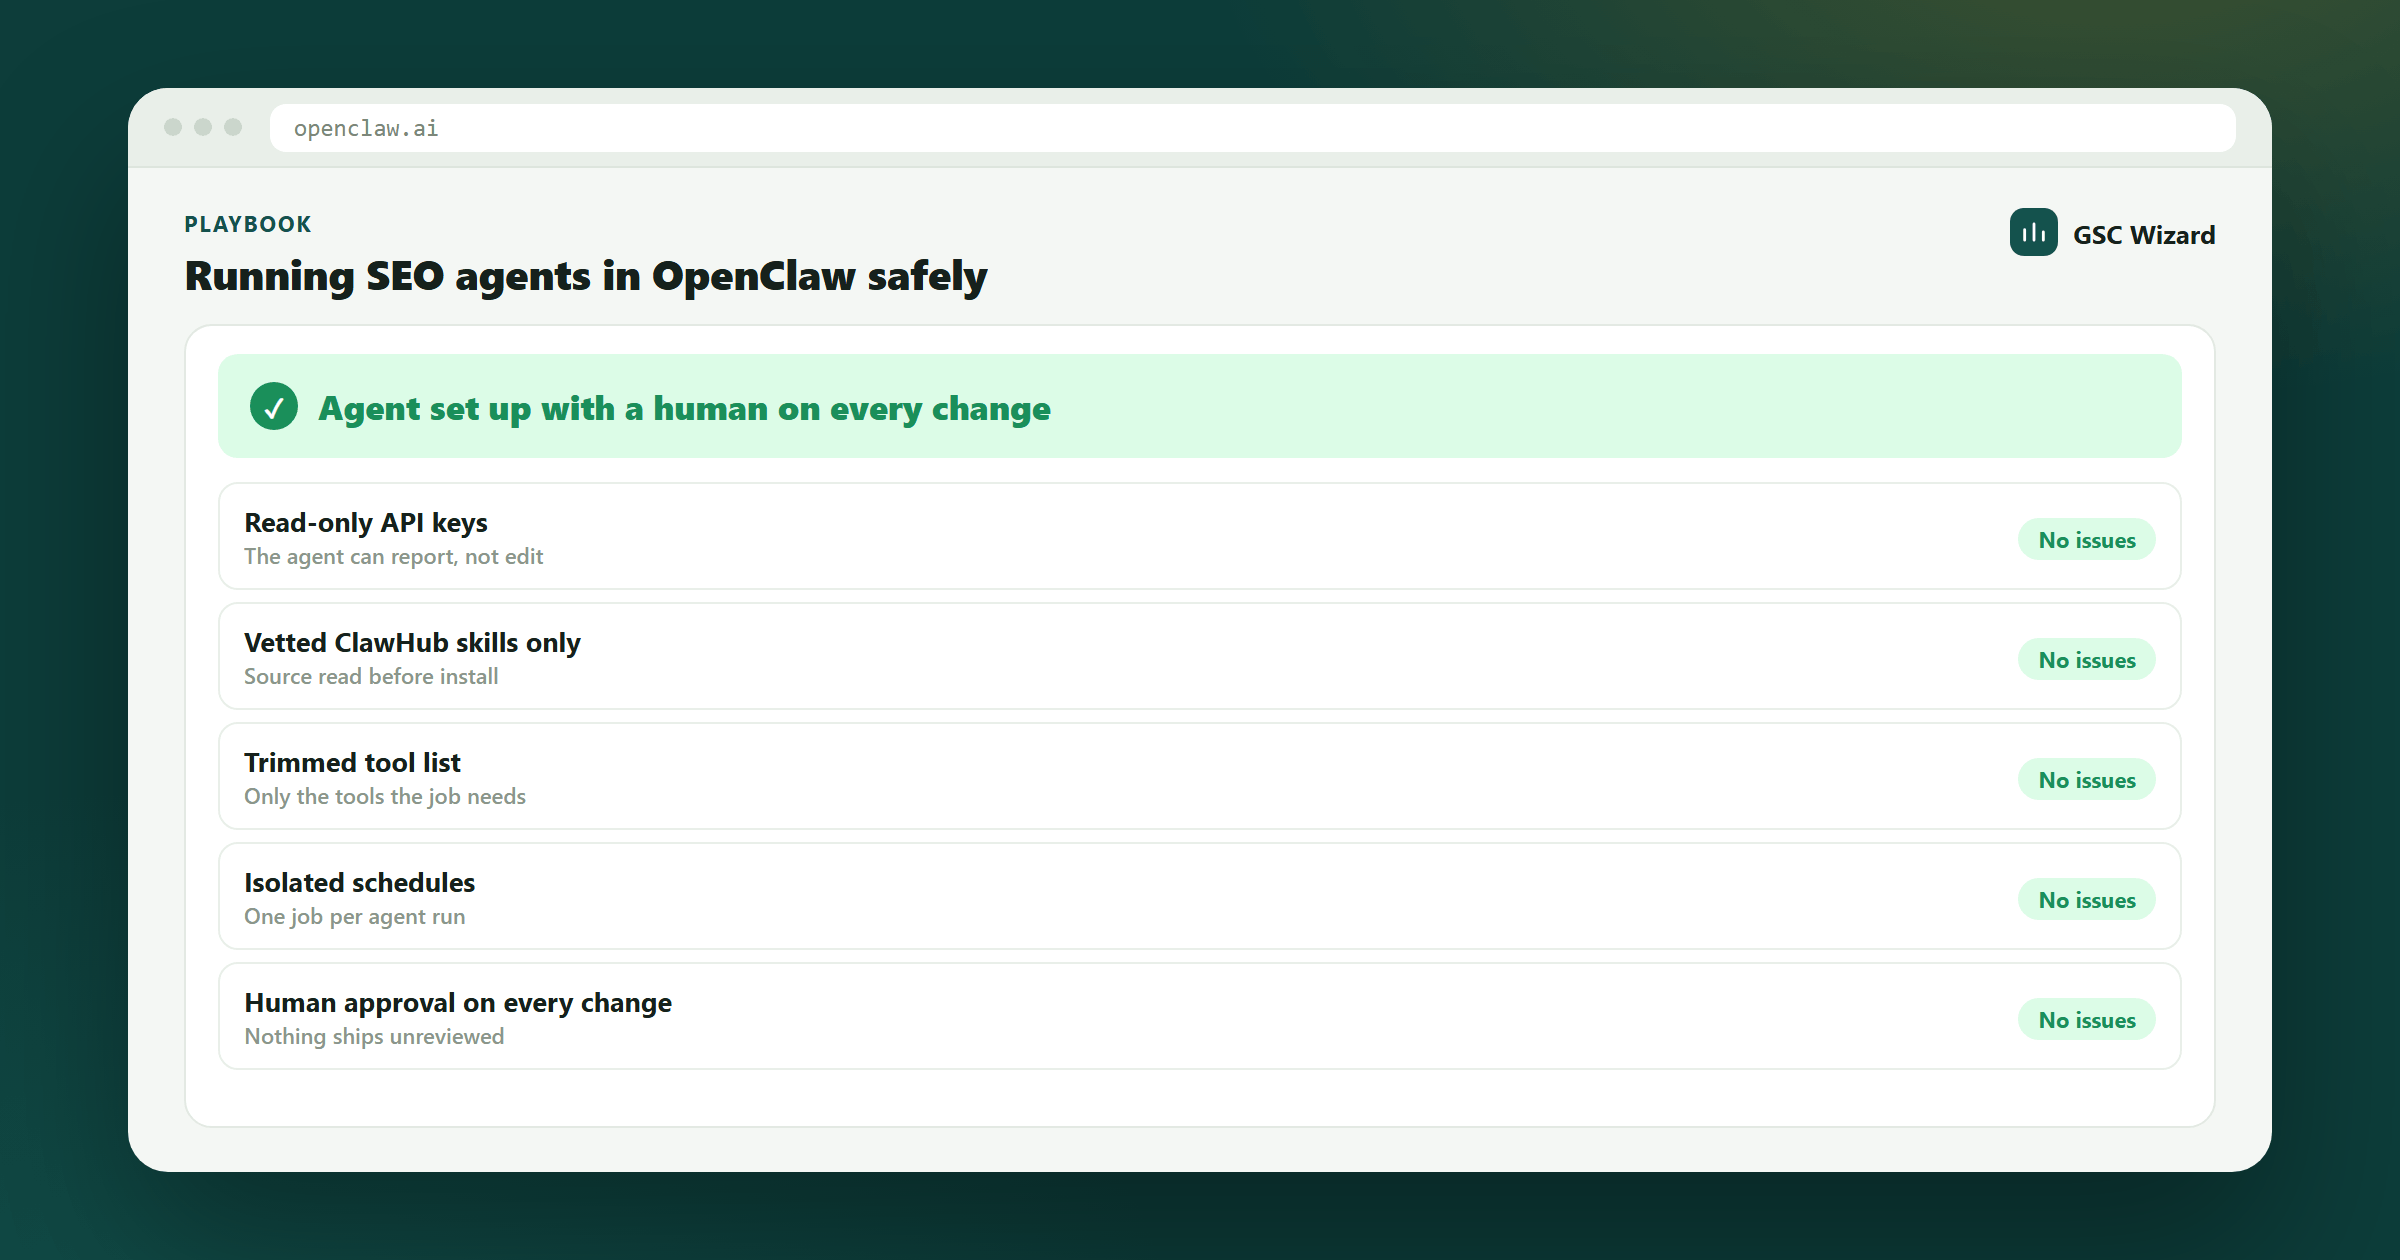
Ein SEO-Setup mit OpenClaw, das Sie laufen lassen können, ohne sich Sorgen zu machen.
30 Minuten, um ein bestehendes Setup anhand der Checkliste zu prüfen.
Zugriff auf die openclaw.json Ihres Gateways und auf die Schlüssel, die Ihre SEO-Tools ausgestellt haben.
1. Jeden Agent schreibgeschützt starten
Ein SEO-Agent verbringt fast seine gesamte Zeit mit Lesen: Performance-Daten, Indexierungsstatus, Seiten von Wettbewerbern. Schreiben (URLs einreichen, Sitemaps bearbeiten, Properties ändern, Beiträge veröffentlichen) kommt selten vor, und genau dort kosten Fehler Sie etwas. Stellen Sie überall dort Schlüssel mit reinem Lesezugriff aus, wo der Dienst das unterstützt. In GSC Wizard wird ein Lese-Schlüssel von jedem schreibenden Tool abgewiesen, bevor der Handler läuft, die Grenze hält also auch dann, wenn der Agent dazu überredet wird, es zu versuchen. Braucht ein Workflow tatsächlich Schreibzugriff, geben Sie genau diesem einen Job einen eigenen Schlüssel, damit Sie ihn widerrufen können, ohne alles andere lahmzulegen.
2. Jeden ClawHub-Skill als Code behandeln, den Sie gleich ausführen
Denn das ist er. Die Sicherheitsdokumentation von OpenClaw selbst sagt, man solle „Skill-Ordner als vertrauenswürdigen Code behandeln“. Im Februar 2026 platzierte die Kampagne ClawHavoc 341 schädliche Skills auf ClawHub, von denen die meisten hinter einer falschen „Voraussetzung“ einen macOS-Infostealer installierten. ClawHub prüft Uploads inzwischen, aber veröffentlichen kann weiterhin jeder, und SEO-Skills sind eine naheliegende Tarnung, weil sie berechtigterweise nach API-Schlüsseln fragen. Führen Sie clawhub inspect aus, lesen Sie SKILL.md und jedes Skript und prüfen Sie, wohin jede Zugangsdaten-Information gesendet wird. Bevorzugen Sie Skills, die nur aus Anweisungen bestehen. Noch besser: Schreiben Sie Ihren eigenen, denn ein guter SEO-Skill besteht aus zwanzig Zeilen Markdown.
3. Daten von MCP-Servern beziehen, Vorgehensweisen aus Skills
Ein Remote-MCP-Server eines Anbieters belässt den Austausch der Zugangsdaten beim Anbieter, und seine Tools durchlaufen wie alles andere die Tool-Richtlinie von OpenClaw. Ein Community-Skill, der dieselbe API aufruft, bedeutet meist Community-Code auf Ihrem Gateway, der Ihr Token hält, manchmal über ein Drittanbieter-Gateway geleitet, das Sie nie gewählt haben. Nutzen Sie MCP für „woher die Zahlen kommen“ und Skills für „was man damit tut“. Die Anleitung zu SEO-Plugins und MCP für OpenClaw listet die Anbieter-Server auf, die sich zu verbinden lohnen.
4. Transport festlegen und die Verbindung testen
Die häufigste Meldung „Mein MCP-Server funktioniert nicht“ hat eine einzeilige Ursache. Ohne Angabe von transport verwendet OpenClaw SSE, und die meisten aktuellen SEO-Server sprechen Streamable HTTP. Setzen Sie "transport": "streamable-http" ausdrücklich und tragen Sie Server unter mcp.servers ein (nicht unter dem Schlüssel mcpServers von Claude Desktop, den viele Anleitungen übernehmen). Führen Sie dann openclaw mcp doctor <name> --probe aus. Das Speichern einer Konfiguration beweist nichts; ein Probe-Test schon.
5. Nur die Tools laden, die der Job braucht
Name, Beschreibung und Schema jedes verbundenen Tools werden in jeder Runde an das Modell gesendet. Verbinden Sie die Search Console, eine SEO-Plattform und einen Crawler, können Sie Zehntausende Tokens für Tool-Menüs ausgeben, bevor der Agent eine einzige Zeile liest, und das Modell wählt zugleich schlechter das richtige Tool aus vierhundert fast gleichbedeutenden aus. Nutzen Sie --include beim Hinzufügen eines Servers, um nur die Tool-Familien zu behalten, die ein bestimmter Agent braucht, und geben Sie unterschiedlichen Jobs unterschiedliche Agents statt eines Agents mit allem.
6. Geheimnisse aus der openclaw.json heraushalten
Ein in einen Header eingefügtes Bearer-Token funktioniert, und openclaw mcp doctor warnt Sie zu Recht davor. Sobald eine Verbindung bewiesen ist, verschieben Sie den Wert in den Secrets-Mechanismus von OpenClaw. Committen Sie die Konfigurationsdatei nie, und rotieren Sie Schlüssel, indem Sie einen neuen ausstellen und den alten widerrufen, nicht durch Überschreiben.
7. Den Agent, der das Web liest, vom Agent trennen, der Schlüssel hält
Seiten von Wettbewerbern, SERP-Snippets und abgerufenes HTML sind nicht vertrauenswürdige Eingaben, und jedes davon kann Anweisungen enthalten, die sich an einen Agent richten. Die Hinweise von OpenClaw zur Prompt-Injection empfehlen, exec, browser, web_fetch und web_search auf vertrauenswürdige Agents oder Allowlists zu beschränken und einen schreibgeschützten „Reader“-Agent einzusetzen, der nicht vertrauenswürdige Inhalte zusammenfasst. Für SEO heißt das: Der Agent, der Wettbewerber durchsucht, fasst zusammen, was er sieht, und übergibt Text. Der Agent mit Ihren Schlüsseln für Search Console und Plattform öffnet selbst nie eine Seite. Führen Sie openclaw security audit aus, nachdem Sie einen der beiden geändert haben.
8. Jede Zahl braucht eine Quelle und einen Zeitraum
Klicks aus der Search Console sind gemessen. Traffic, Suchvolumen und Schwierigkeit von Drittanbietern sind modelliert. Nichts in MCP sagt dem Modell, was davon was ist, daher mischt eine Tabelle der „Top-Chancen“ beides bereitwillig. Legen Sie die Regel in Ihrem Skill fest: Jede Zahl nennt das Tool, das sie erzeugt hat, und den Zeitraum, und modellierte Werte werden als Schätzungen gekennzeichnet. Bevorzugen Sie Server, die aggregieren, bevor sie antworten. Ein Modell, das 25.000 abgeschnittene Zeilen summiert, meldet eine falsche Summe genauso selbstsicher wie eine richtige. Lässt sich eine Zahl nicht auf einen Tool-Aufruf zurückführen, gehört sie nicht in einen Bericht.
9. Mit Automationen planen, in isolierten Sessions und in vernünftigem Takt
Nutzen Sie openclaw automations create (Alias openclaw cron) mit --session isolated, damit geplante Läufe Ihre Hauptunterhaltung nicht füllen, und mit einem Zustellziel (--announce an einen Kanal oder --webhook an Ihr eigenes System). Verwenden Sie Heartbeat nicht für Datenabrufe: Es läuft standardmäßig alle 30 Minuten in der Hauptsession, und die Daten der Search Console ändern sich nicht so oft. Die finalen Zahlen der Search Console hinken außerdem etwa zwei bis drei Tage hinterher, ein täglicher Check sollte daher nur vollständige Tage vergleichen. Die Anleitung zur kontinuierlichen SEO-Analyse enthält einen fertigen Skill mit täglichem, wöchentlichem und monatlichem Takt.
10. Bei jeder Änderung an der Live-Website einen Menschen einbinden
Analysen dürfen autonom laufen. Änderungen nicht. Die Exec-Freigaben von OpenClaw lassen Shell-Befehle auf Richtlinie, Allowlist und optionale Nutzerfreigabe warten, und MCP-Server lassen sich mit openclaw mcp configure <server> --approval prompt hinter eine Freigabe stellen. Nutzen Sie beides für alles, was veröffentlicht, weiterleitet, löscht oder einreicht. Und widerstehen Sie der naheliegenden Versuchung: Ein Agent, der veröffentlichen darf, veröffentlicht zu viel. Dünne KI-Seiten verwässern das Crawl-Budget und schieben weitere URLs in „Gefunden – zurzeit nicht indexiert“. Der tägliche SEO-Agent plädiert dafür, Ihren Agent stattdessen auf Bereinigung und interne Links anzusetzen.
Bonus: die andere Seite von SEO mit OpenClaw
OpenClaw-Nutzer sind auch Suchende. Recherchiert der Agent von jemandem einen Kauf, fragt er einen web_search-Anbieter ab (je nach Konfiguration Brave, Exa, Tavily, Perplexity, Firecrawl, SearXNG oder DuckDuckGo) und öffnet Ihre Seite womöglich in einem Headless-Browser. Keiner davon ist Google. Besonders Brave betreibt einen eigenen Index mit eigenen Aufnahmeregeln, behandelt in So ranken Sie in der Brave Search. Serverseitig gerenderte Inhalte, saubere Canonicals und keine pauschalen Bot-Sperren helfen bei allen.
Die Checkliste
- Schlüssel mit Lesezugriff für jeden geplanten Agent; Schreib-Schlüssel nur pro Job.
- Jeder ClawHub-Skill geprüft, seine Skripte gelesen und die Ziele seiner Zugangsdaten bekannt.
- Daten über MCP-Server der Anbieter, Vorgehensweisen über Ihre eigenen Skills.
transport: "streamable-http"gesetzt undopenclaw mcp doctor --probeerfolgreich.- Tool-Listen gekürzt mit
--include, ein Agent pro Job. - Keine Klartext-Tokens in der
openclaw.json; die Konfiguration wird nie committet. - Agents, die das Web lesen, halten keine Schlüssel;
openclaw security auditist sauber. - Jede berichtete Zahl nennt ihr Tool und ihren Zeitraum; modellierte Daten sind gekennzeichnet.
- Zeitpläne sind isolierte Automationen auf Basis vollständiger Tage, nicht Heartbeat.
- Freigabe erforderlich für alles, was die Live-Website verändert.
Nächstes Playbook
Läuft der Agent sicher, setzen Sie ihn auf Arbeit an, die sich auszahlt. Striking-Distance-Keywords finden → ist ein guter erster Job für eine wöchentliche Durchsicht: Positionen 4 bis 20, echte Impressionen und Fixes, die Sie noch am selben Tag ausspielen können.
Geschrieben von Jan-Willem Bobbink · Veröffentlicht am 5. Oktober 2026