Bonnes pratiques SEO avec OpenClaw : 10 règles pour faire tourner des agents SEO
OpenClaw permet de donner très facilement à un agent accès à votre Search Console, à vos outils d'analyse et à votre plateforme SEO, de le planifier et de le laisser vous parler sur Slack ou Telegram. Il permet tout aussi facilement de confier votre jeton Google au script d'un inconnu, de consommer un mois d'unités d'API en un week-end, ou d'agir sur un chiffre inventé par le modèle. Ces dix règles couvrent les erreurs les plus faciles à commettre. La plupart portent sur ce qu'il ne faut pas laisser faire à l'agent.
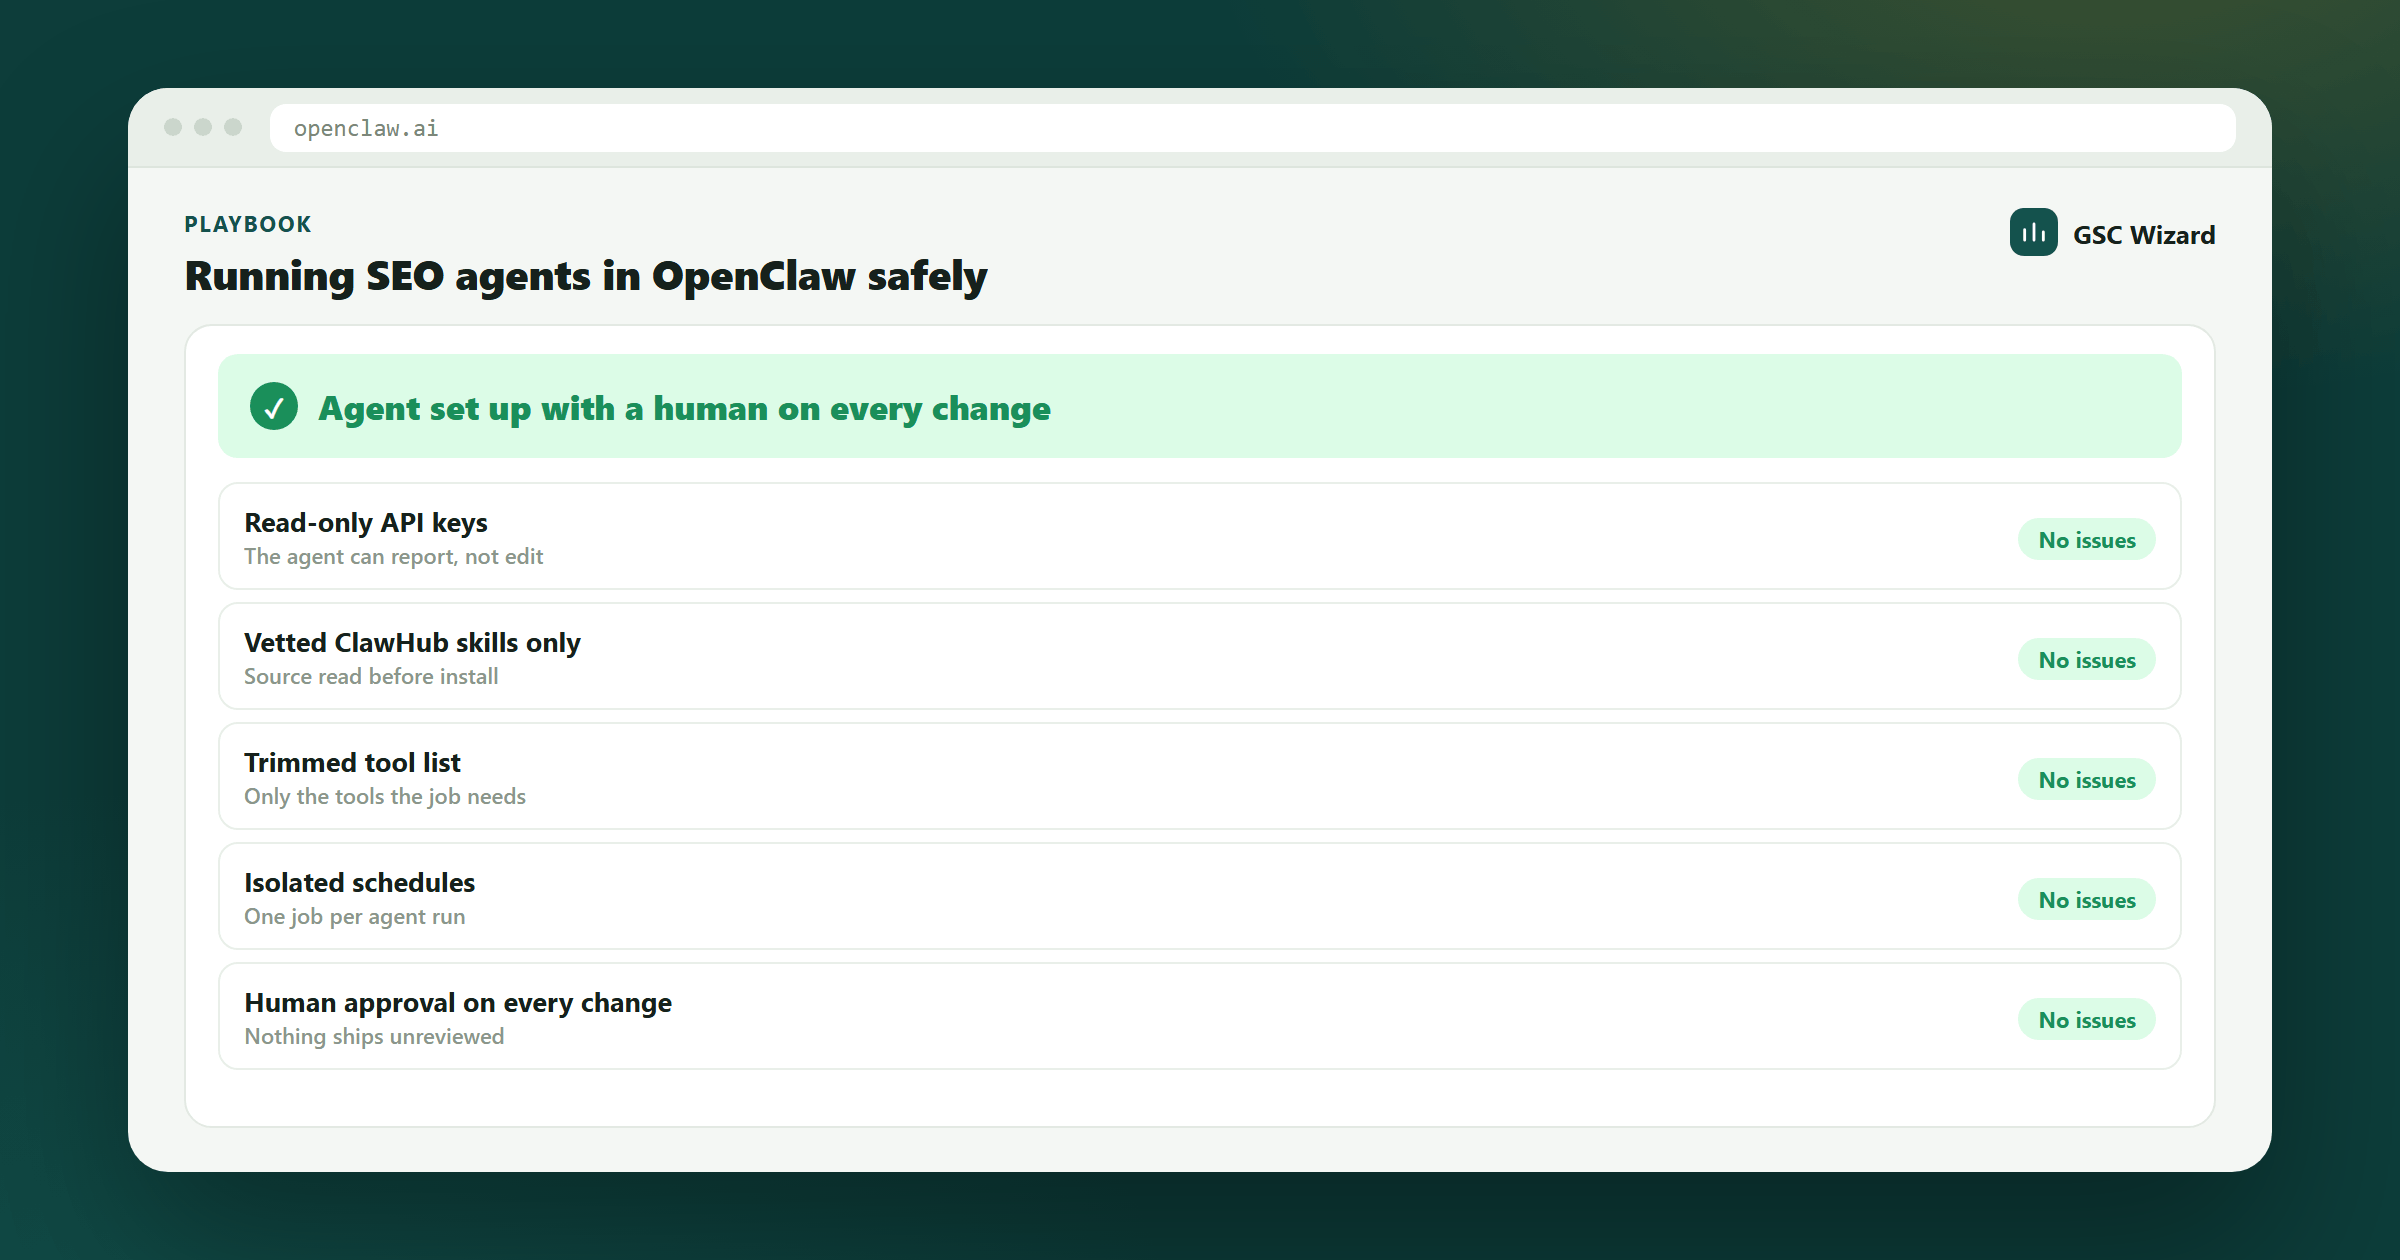
Une configuration SEO OpenClaw que vous pouvez laisser tourner sans vous inquiéter.
30 minutes pour auditer une configuration existante à l'aide de la checklist.
L'accès au fichier openclaw.json de votre Gateway et aux clés émises par vos outils SEO.
1. Démarrer chaque agent en lecture seule
Un agent SEO passe presque tout son temps à lire : données de performance, statut d'indexation, pages de concurrents. Écrire (soumettre des URL, modifier des sitemaps, changer des propriétés, publier des articles) est rare, et c'est là que les erreurs coûtent cher. Émettez des clés limitées à la lecture partout où le service le permet. Dans GSC Wizard, une clé de lecture est refusée par tous les outils de modification avant même l'exécution du gestionnaire : la limite tient donc même si l'agent se laisse convaincre d'essayer. Quand un workflow doit vraiment écrire, donnez à cette tâche sa propre clé, afin de pouvoir la révoquer sans tout casser.
2. Traiter chaque skill ClawHub comme du code que vous allez exécuter
Parce que c'en est. La documentation de sécurité d'OpenClaw dit elle-même de « traiter les dossiers de skills comme du code de confiance ». En février 2026, la campagne ClawHavoc a placé 341 skills malveillants sur ClawHub, la plupart installant un voleur d'informations pour macOS derrière un faux « prérequis ». ClawHub analyse désormais les envois, mais la publication reste ouverte à tous, et les skills SEO sont un déguisement idéal puisqu'ils demandent légitimement des clés d'API. Lancez clawhub inspect, lisez SKILL.md et chaque script, et vérifiez où part chaque identifiant. Privilégiez les skills composés uniquement d'instructions. Mieux encore, écrivez les vôtres : un bon skill SEO tient en vingt lignes de Markdown.
3. Les données viennent des serveurs MCP, les procédures des skills
Le serveur MCP distant d'un éditeur garde l'échange d'identifiants entre vous et lui, et ses outils passent par la politique d'outils d'OpenClaw comme tout le reste. Un skill communautaire qui appelle la même API implique en général du code communautaire sur votre Gateway, détenant votre jeton, parfois acheminé par une passerelle tierce que vous n'avez jamais choisie. Utilisez MCP pour « d'où viennent les chiffres » et les skills pour « que faire avec ». Le guide des plugins SEO et du MCP pour OpenClaw recense les serveurs d'éditeurs qui valent la peine d'être connectés.
4. Définir le transport et tester la connexion
Le signalement le plus fréquent, « mon serveur MCP ne fonctionne pas », a une cause qui tient en une ligne. Quand transport est omis, OpenClaw utilise SSE, alors que la plupart des serveurs SEO actuels parlent Streamable HTTP. Définissez explicitement "transport": "streamable-http" et placez les serveurs sous mcp.servers (et non sous la clé mcpServers de Claude Desktop que de nombreux guides recopient). Lancez ensuite openclaw mcp doctor <name> --probe. Enregistrer une configuration ne prouve rien ; un test de connexion, si.
5. Ne charger que les outils dont la tâche a besoin
Le nom, la description et le schéma de chaque outil connecté sont envoyés au modèle à chaque tour. Connectez Search Console, une plateforme SEO et un crawler, et vous pouvez dépenser des dizaines de milliers de tokens en menus d'outils avant que l'agent ne lise une seule ligne, tandis que le modèle choisit de plus en plus mal le bon outil parmi quatre cents quasi-synonymes. Utilisez --include lorsque vous ajoutez un serveur pour ne garder que les familles d'outils qu'un agent donné utilise, et confiez des tâches différentes à des agents différents plutôt qu'un seul agent qui a tout.
6. Garder les secrets hors de openclaw.json
Un jeton bearer collé dans un en-tête fonctionne, et openclaw mcp doctor vous en avertira à juste titre. Une fois la connexion validée, déplacez la valeur dans le mécanisme de secrets d'OpenClaw. Ne committez jamais le fichier de configuration, et renouvelez les clés en en émettant une nouvelle puis en révoquant l'ancienne, pas en la modifiant sur place.
7. Séparer l'agent qui lit le web de celui qui détient les clés
Les pages de concurrents, les extraits de SERP et le HTML récupéré sont des entrées non fiables, et chacun peut contenir des instructions destinées à un agent. Les recommandations d'OpenClaw sur la prompt injection conseillent de limiter exec, browser, web_fetch et web_search à des agents de confiance ou à des listes d'autorisation, et d'utiliser un agent « lecteur » en lecture seule pour résumer le contenu non fiable. En SEO, cela signifie que l'agent qui explore les concurrents résume ce qu'il voit et transmet du texte. L'agent qui détient vos clés Search Console et plateforme n'ouvre jamais de page lui-même. Lancez openclaw security audit après avoir modifié l'un ou l'autre.
8. Chaque chiffre doit avoir une source et une période
Les clics de Search Console sont mesurés. Le trafic, le volume et la difficulté issus d'outils tiers sont modélisés. Rien dans MCP ne dit au modèle lequel est lequel : un tableau des « meilleures opportunités » les mélangera donc sans scrupule. Inscrivez la règle dans votre skill : chaque chiffre porte le nom de l'outil qui l'a produit et la période, et les chiffres modélisés sont signalés comme des estimations. Privilégiez les serveurs qui agrègent avant de répondre. Un modèle qui additionne 25 000 lignes tronquées annoncera un total faux avec autant d'assurance qu'un total juste. Un chiffre qui ne peut pas être rattaché à un appel d'outil n'entre pas dans un rapport.
9. Planifier avec des automatisations, en sessions isolées, à une cadence raisonnable
Utilisez openclaw automations create (alias openclaw cron) avec --session isolated, pour que les exécutions planifiées n'encombrent pas votre conversation principale, ainsi qu'une cible de livraison (--announce vers un canal ou --webhook vers votre propre système). N'utilisez pas Heartbeat pour récupérer des données : il tourne toutes les 30 minutes dans la session principale par défaut, et les données Search Console ne changent pas aussi souvent. Les chiffres définitifs de Search Console accusent en outre environ deux à trois jours de retard : un contrôle quotidien ne doit donc comparer que des jours complets. Le guide de l'analyse SEO continue propose un skill prêt à l'emploi avec des cadences quotidienne, hebdomadaire et mensuelle.
10. Garder un humain sur chaque modification du site en production
L'analyse peut être autonome. Les modifications, non. Les validations d'exécution (exec approvals) d'OpenClaw font attendre les commandes shell derrière une politique, une liste d'autorisation et une validation facultative de l'utilisateur, et les serveurs MCP peuvent être soumis à validation avec openclaw mcp configure <server> --approval prompt. Utilisez les deux pour tout ce qui publie, redirige, supprime ou soumet. Et résistez à la tentation évidente : un agent qui peut publier est un agent qui publiera trop. Des pages IA pauvres diluent le budget de crawl et poussent davantage d'URL vers « Détectée, actuellement non indexée ». L'agent SEO quotidien plaide pour orienter plutôt votre agent vers l'élagage et le maillage interne.
Bonus : l'autre face du SEO avec OpenClaw
Les utilisateurs d'OpenClaw sont aussi des internautes qui cherchent. Quand l'agent de quelqu'un étudie un achat, il interroge un fournisseur web_search (Brave, Exa, Tavily, Perplexity, Firecrawl, SearXNG ou DuckDuckGo, selon la configuration) et peut ouvrir votre page dans un navigateur headless. Aucun d'eux n'est Google. Brave, en particulier, gère son propre index avec ses propres règles d'entrée, détaillées dans comment se classer dans Brave Search. Un contenu rendu côté serveur, des canoniques propres et l'absence de blocage global des bots aident auprès de chacun d'eux.
La checklist
- Des clés limitées à la lecture sur chaque agent planifié ; des clés d'écriture uniquement par tâche.
- Chaque skill ClawHub inspecté, ses scripts lus et les destinations de ses identifiants connues.
- Les données via les serveurs MCP des éditeurs, les procédures via vos propres skills.
transport: "streamable-http"défini etopenclaw mcp doctor --proberéussi.- Listes d'outils allégées avec
--include, un agent par tâche. - Aucun jeton en clair dans
openclaw.json; la configuration n'est jamais committée. - Les agents qui lisent le web ne détiennent aucune clé ;
openclaw security auditne signale rien. - Chaque chiffre rapporté mentionne son outil et sa période ; les données modélisées sont signalées.
- Les planifications sont des automatisations isolées sur des jours complets, pas Heartbeat.
- Validation obligatoire pour tout ce qui modifie le site en production.
Playbook suivant
Une fois l'agent opérationnel en toute sécurité, orientez-le vers un travail rentable. Trouver les mots-clés en striking distance → est une bonne première mission pour une revue hebdomadaire : positions 4 à 20, impressions réelles et correctifs livrables le jour même.
Rédigé par Jan-Willem Bobbink · Publié le 5 octobre 2026