Comment se classer dans Brave Search (et être cité par Claude)
Brave Search ne crawle pas et ne classe pas les pages comme Google. Il s'appuie sur de vraies personnes utilisant le navigateur Brave pour valider une page avant même qu'elle n'entre dans l'index, et ce même index fournit l'essentiel de ce que Claude cite quand il répond avec une recherche web. Voici comment le mécanisme fonctionne réellement, et que faire au lieu de cliquer sur « Submit URL » en espérant.
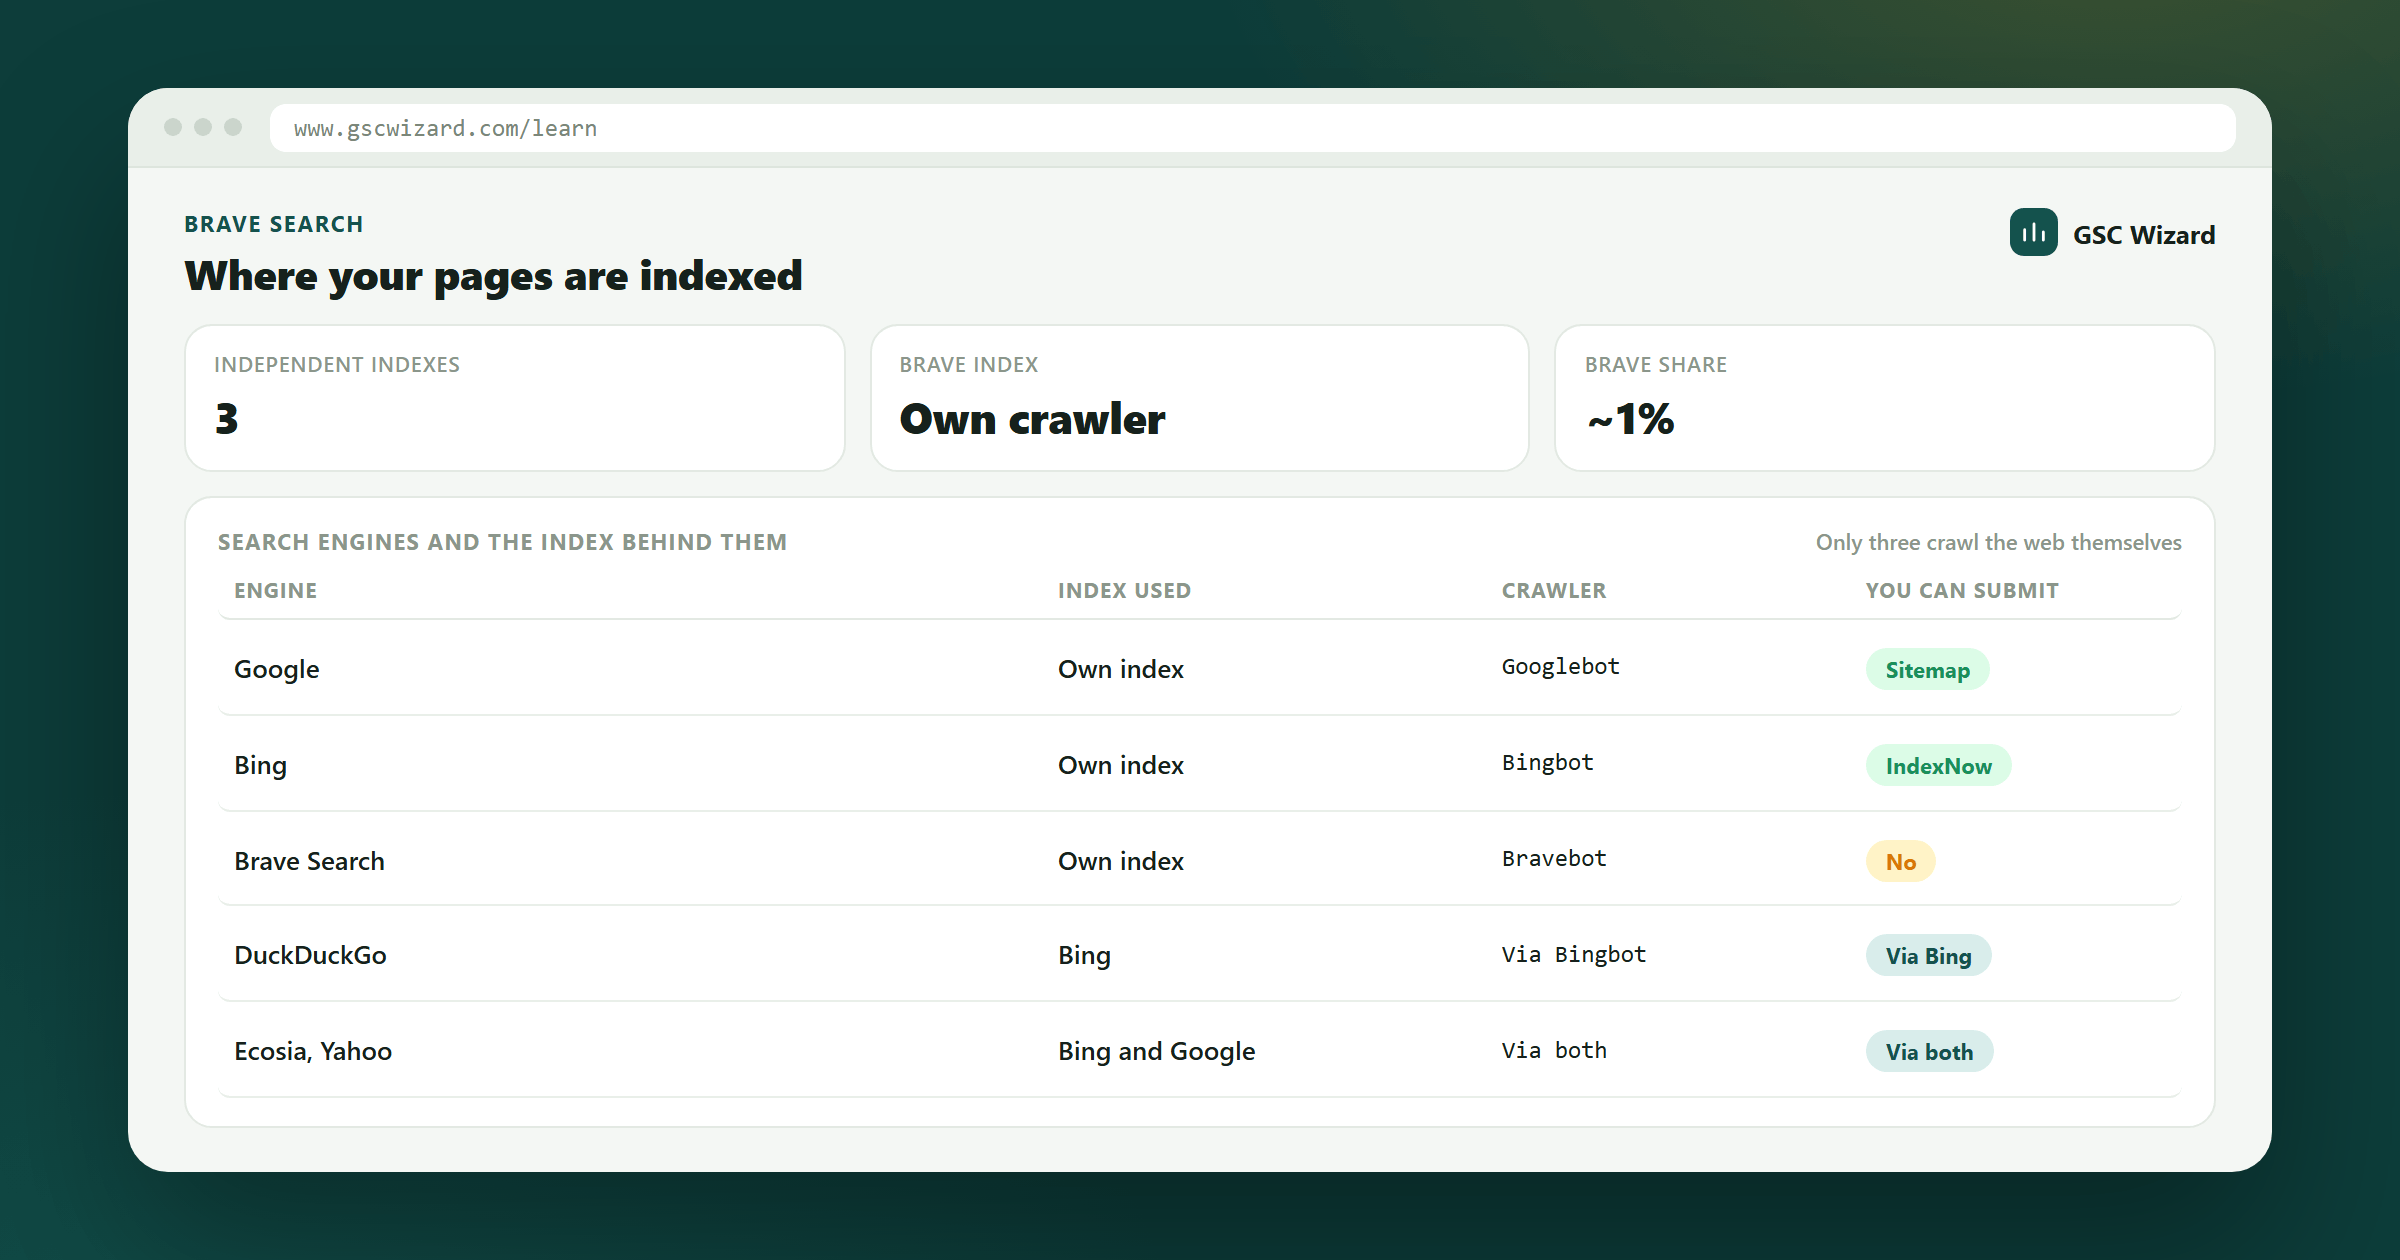
Faire repérer de vraies pages indexables par le Web Discovery Project de Brave et, par ricochet, parmi les sources que Claude cite.
20 minutes d'audit. Les résultats dépendent du trafic réel, pas d'un formulaire.
L'accès au robots.txt et aux règles de bots du serveur ou du CDN, ainsi qu'un minimum de visibilité existante sur Google, Bing ou DuckDuckGo.
Pourquoi « il suffit de soumettre l'URL » est un mauvais conseil
Un conseil qui circule sans cesse : Brave est le principal moteur de recherche de Claude, Brave propose un outil « Submit URL » sur search.brave.com, donc si vous voulez que votre contenu apparaisse plus vite dans Claude, soumettez-y vos pages importantes. L'histoire est bien ficelée, et elle est trompeuse d'une manière qui peut vous coûter plus qu'elle ne vous rapporte.
La seule fonction documentée de cet outil est de forcer Brave à recharger une URL qu'il connaît déjà. Ce n'est pas une soumission à l'index et il ne garantit pas l'indexation d'un nouveau contenu. Il est conçu pour « j'ai corrigé quelque chose, regardez à nouveau », pas pour « découvrez cette page ». Utilisé pour le premier cas, il est inoffensif. Utilisé comme stratégie de découverte, c'est un levier qui n'est relié à rien.
Le vrai sujet est ce qui conditionne réellement l'entrée d'une nouvelle page dans l'index de Brave, et cela n'a rien à voir avec un formulaire.
Comment Brave trouve réellement les nouvelles pages : deux portes, pas une
Brave n'a ni search console, ni soumission de sitemap, ni équivalent d'IndexNow. La découverte passe par le Web Discovery Project (WDP), une fonction facultative du navigateur Brave qui signale anonymement les pages sur lesquelles arrivent les utilisateurs participants. L'article du centre d'aide de Brave confirme qu'elle repose strictement sur le consentement et que les données transmises « ne peuvent pas être rattachées à la personne qui les a transmises ». On estime qu'environ 120 millions de personnes en font partie. Si aucune d'elles n'arrive jamais sur votre page, rien d'autre n'a d'importance. Il y a deux voies d'entrée, avec des seuils très différents.
Page Channel : la porte difficile
Il faut environ 20 utilisateurs différents du WDP, ayant activé l'option et issus de réseaux différents, qui arrivent indépendamment sur la page. Les signaux sont protégés par le protocole cryptographique STAR de Brave, qui repose sur la k-anonymité : une valeur ne devient lisible que lorsqu'assez d'utilisateurs indépendants l'ont transmise. La note de conception de Brave décrit le mécanisme mais ne publie pas le quorum exact ; le chiffre d'environ 20 pour le Web Discovery Project lui-même provient des tests indépendants de MERJ, présentés plus bas. Dans tous les cas, sous le seuil, les serveurs de Brave ne peuvent littéralement ni déchiffrer ni reconstituer le contenu de la page : c'est un mécanisme de confidentialité, pas un filtre antispam arbitraire, mais l'effet pratique est le même : une page toute neuve sans trafic réel peut rester invisible pour Brave indéfiniment.
Query Channel : la porte facile
Il suffit d'un seul utilisateur ayant activé l'option qui effectue une recherche sur Google, Bing, Yahoo ou DuckDuckGo où votre page est déjà classée. Le client de Brave reconnaît la page de résultats, en recharge anonymement une version nettoyée après un délai aléatoire de 1 à 20 minutes, et en extrait les URL, sans quorum de 20 personnes.
À retenir concrètement : le moyen le plus rapide d'entrer dans l'index de Brave est généralement d'être déjà classé ailleurs. Une page sans aucune visibilité sur Google, Bing ou DuckDuckGo doit franchir le seuil plus difficile des 20 personnes, qui dépend spécifiquement du trafic organique de personnes utilisant le navigateur Brave, une part de votre audience totale bien plus petite que « n'importe quel visiteur ».
La checklist technique : s'assurer que Brave peut seulement voir la page
Même quand une page est éligible à la découverte, elle doit passer la vérification en « double fetch » de Brave : un rechargement anonyme, sans connexion, qui confirme que la page apparaît identique pour tout le monde. Cette vérification applique des règles plus strictes que Googlebot :
- Aucun JavaScript n'est exécuté. Le contenu qui n'apparaît qu'après un rendu côté client est invisible pour cette vérification. Si une page dépend de JS pour son contenu principal, rendez-la côté serveur ou pré-rendez-la.
- Les redirections disqualifient une page. Toute redirection dans la chaîne la marque comme privée, y compris des schémas de redirection que Google tolère sans problème.
- Limites de performance strictes. Le chargement est interrompu au bout de 10 secondes et refuse les réponses de plus de 2MB. Un temps de premier octet lent ou des pages surchargées échouent en silence, sans aucun rapport pour vous dire pourquoi.
- Seuls les signaux HTML comptent. Un
noindexenvoyé via l'en-tête HTTPX-Robots-Tagn'est pas lu : seule une balise<meta name="robots" content="noindex">dans le<head>HTML est prise en compte. Les canoniques ne sont lues qu'à partir d'un élément<link rel="canonical">, jamais d'un en-tête. Si votre CMS les définit via des en-têtes, la vérification de Brave peut porter sur une page qui ne reflète pas du tout votre intention. - Les query strings sont risquées sans canonique. Un deuxième paramètre d'URL, ou une query string de plus de 22 caractères environ, marque la page comme privée s'il n'y a pas de balise canonique explicite pointant vers une URL propre.
- Certains mots dans le chemin paraissent risqués. Les chemins contenant des mots comme
login,token,checkout,account,adminouwp-adminsont traités avec plus de méfiance. Évitez-les dans vos URL canoniques marketing.
Ne laissez pas le robots.txt bloquer Bravebot en silence
La page d'aide sur le crawler de Brave Search le confirme directement : « le crawler de Brave Search n'affiche pas de user agent distinct, car nous devons éviter toute discrimination de la part des sites qui n'autorisent que Google à les crawler », et « si un domaine ou une page n'est pas crawlable par Googlebot, le bot de Brave Search ne la crawlera pas non plus ». Concrètement, un schéma de sécurité courant (« bloquer tout bot que nous ne reconnaissons pas explicitement » dans le robots.txt, ou une règle WAF/CDN qui n'autorise que des crawlers nommés) peut exclure Brave en silence, avec tous les scrapers qu'il devait arrêter. Il n'y a aucun message d'erreur : la page n'est simplement jamais récupérée. Vérifiez si votre robots.txt contient un Disallow global et examinez les règles de bots au niveau du serveur ou du CDN (Cloudflare et les WAF similaires sont des coupables fréquents) avant de croire qu'un problème de découverte ou de ranking tient à la qualité du contenu.
Attendez-vous à de la volatilité, pas à de la stabilité
L'index de Brave est considérablement plus petit que celui de Google et semble accorder beaucoup de poids aux signaux récents. Brave décrit lui-même les données sous-jacentes comme impossibles à relier à un utilisateur, un appareil ou une session, ce qui répond à un objectif de conception différent de la stabilité. En pratique, plusieurs SEO qui suivent Brave de près décrivent un schéma reconnaissable : une page est repérée, se classe bien pendant quelques semaines, puis disparaît tout aussi vite, avant parfois de revenir plus tard. Brave n'a pas publié les mécanismes exacts, considérez donc cela comme un schéma observé plutôt que documenté, mais il correspond au comportement habituel d'un index plus petit qui privilégie la fraîcheur. Ne réagissez pas à une variation de classement dans Brave comme vous réagiriez à une core update de Google. Considérez les gains comme un bonus par-dessus le trafic réel, pas comme une métrique à défendre semaine après semaine.
Faut-il utiliser soi-même le navigateur Brave ?
C'est une tactique modeste, vraiment peu coûteuse, qui mérite d'être envisagée, mais ce n'est pas une stratégie à plein temps. Télécharger Brave et activer le Web Discovery Project envoie des signaux anonymes de navigation et de recherche qui contribuent à construire l'index. Visiter vos propres pages publiées avec l'option activée peut constituer l'un des 20 signaux nécessaires à une nouvelle page, ou l'unique signal qui déclenche le Query Channel si vous recherchez une requête pour laquelle la page est déjà classée ailleurs. Cela ne changera pas la donne à lui seul et ne remplace pas de vrais visiteurs, mais il n'y a pas non plus d'inconvénient réel à le faire.
Pourquoi cela décide aussi si Claude vous cite
Anthropic n'a pas confirmé cette relation dans une annonce produit, mais la liste des sous-traitants de son propre Trust Center mentionne Brave Search, et deux études indépendantes la corroborent. L'analyse initiale de Profound (mars 2025) a relevé un recoupement de 86,7 % entre les citations de Claude et les premiers résultats de Brave, statistiquement bien au-delà du hasard (p < 0,0001). Une étude de suivi de MERJ, plus large, portant sur environ 35 000 citations de Claude pour 400 requêtes (juillet 2026), aboutit à un résultat quasi identique : 79,2 % des URL citées par Claude figurent dans le top 10 de Brave pour la requête correspondante, contre seulement 34 % pour le top 10 de Google. Un article de Search Engine Land ajoute que Claude ne semble pas reclasser les résultats de Brave : il les utilise presque tels quels.
Concrètement, tout ce qui précède (être crawlable par Brave, éligible au double fetch, réellement indexé et bien classé) est un levier plus direct pour la visibilité dans Claude que tout ce qui cible Google seul. Si vous n'optimisez que pour Google, vous optimisez pour le plus petit des deux recoupements.
La checklist
- Auditez le robots.txt et toutes les règles WAF/bots pour repérer un blocage global qui pourrait exclure Bravebot en silence.
- Vérifiez que le contenu principal est rendu côté serveur (pas uniquement en JS), évitez les chaînes de redirections et gardez les pages largement sous les limites du double fetch de 10 secondes / 2MB.
- Utilisez une vraie balise
<link rel="canonical">, pas seulement un en-tête, et gardez des URL canoniques sans paramètres d'URL inutiles. - Construisez ou confirmez une vraie visibilité de ranking sur Google, Bing ou DuckDuckGo. C'est la porte rapide du Query Channel vers Brave.
- S'il n'y a pas de classement existant sur lequel s'appuyer, concentrez-vous sur une vraie promotion susceptible d'atteindre les utilisateurs du navigateur Brave : une vraie construction d'audience, pas des formulaires de soumission.
- N'utilisez Submit URL qu'après une vraie correction, pour forcer un nouvel examen. Pas comme mécanisme de découverte.
- Ne paniquez pas face aux variations de classement à court terme dans Brave. Considérez la visibilité durable comme le signal, pas le bruit d'une semaine à l'autre.
- Si vous le souhaitez, utilisez vous-même Brave avec le Web Discovery Project activé. Cela ne coûte presque rien et fait de vous l'un de vos propres signaux.
Playbook suivant
GSC Wizard ne suit pas Brave (aucune console tierce ne le fait pour l'instant), mais les problèmes d'exploration qui bloquent discrètement Bravebot touchent en général aussi les vrais utilisateurs et les autres robots. Commencez par diagnostiquer les problèmes techniques d'indexation → sur votre propre site : cela couvre les problèmes de robots.txt et de canonical qui comptent pour tous les moteurs, pas seulement pour Google.
Rédigé par Jan-Willem Bobbink · Publié le 28 août 2026