Ihre robots.txt-Datei teilt Suchmaschinen-Crawlern mit, welche Seiten sie crawlen dürfen (oder nicht). So hängt sie mit der Google Search Console zusammen:
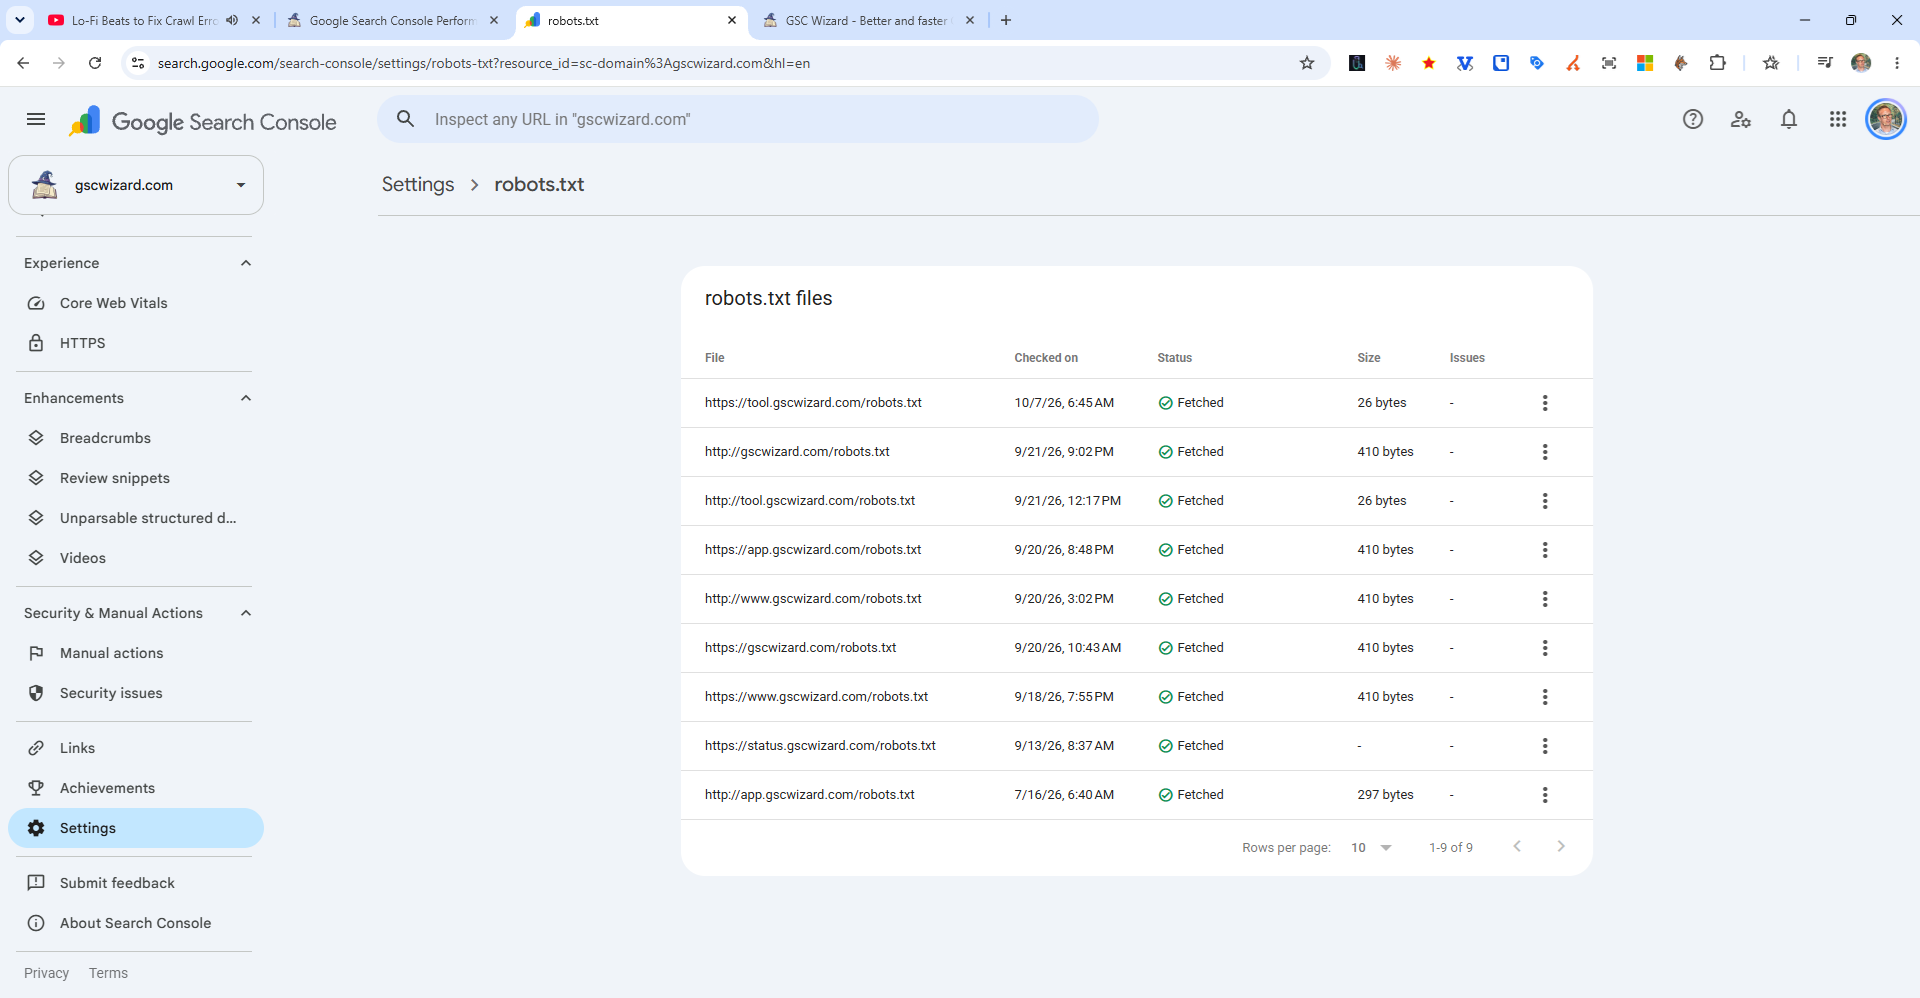
Ihre Robots.txt prüfen
Rufen Sie https://yourdomain.com/robots.txt direkt in Ihrem Browser auf. Sie sollten eine reine Textdatei sehen.
Prüfen, ob eine bestimmte Seite gesperrt ist
Nutzen Sie das URL-Prüftool in der Search Console: Es zeigt Ihnen im Bereich der Crawling-Details ausdrücklich an, ob eine Seite „Durch robots.txt blockiert“ ist.
Best Practices für die Robots.txt
- Sperren Sie KEINE Seiten, die indexiert werden sollen (auch keine CSS- und JS-Dateien)
- Sperren Sie Admin-Bereiche, Login-Seiten, Dankeseiten und doppelte Parameter-URLs
- Tragen Sie Ihre Sitemap-URL in die robots.txt ein:
Sitemap: https://yourdomain.com/sitemap.xml - Verwenden Sie die robots.txt nie, um eine Seite aus der Suche herauszuhalten, sondern stattdessen noindex (gesperrte Seiten können trotzdem in der Suche erscheinen, wenn Links auf sie zeigen)
Robots.txt-Tester
Google hat den robots.txt-Tester 2022 aus der Search Console entfernt. Sie können den eigenständigen robots.txt-Tester oder Tools von Drittanbietern nutzen.