Il tuo file robots.txt indica ai crawler dei motori di ricerca quali pagine possono (o non possono) scansionare. Ecco come si collega a Google Search Console:
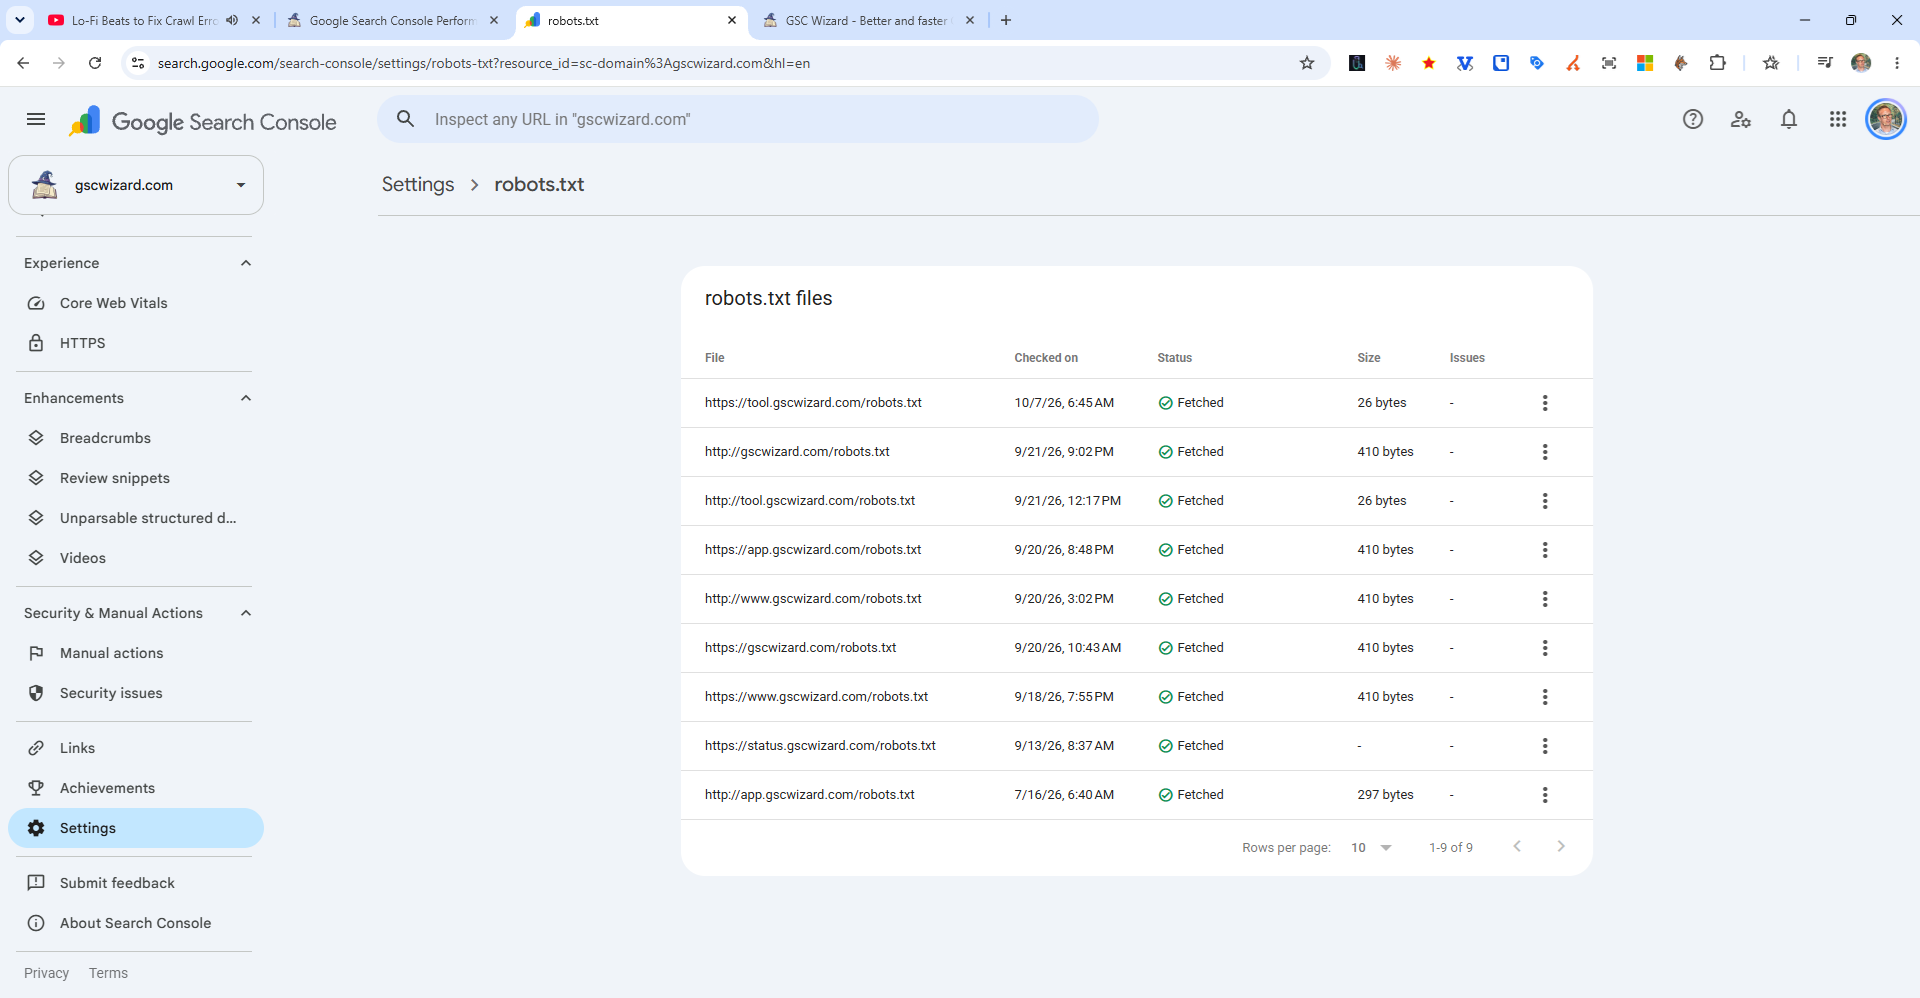
Come controllare il tuo robots.txt
Apri https://yourdomain.com/robots.txt direttamente nel browser. Dovresti vedere un file di testo semplice.
Come verificare se una pagina specifica è bloccata
Usa lo strumento Controllo URL in Search Console: nella sezione dei dettagli di scansione ti dirà esplicitamente se una pagina è “Bloccata da robots.txt”.
Buone pratiche per il robots.txt
- NON bloccare le pagine che vuoi indicizzare (compresi i file CSS e JS)
- Blocca i pannelli di amministrazione, le pagine di login, le pagine di ringraziamento e gli URL duplicati con parametri
- Indica l'URL della tua sitemap nel robots.txt:
Sitemap: https://yourdomain.com/sitemap.xml - Non usare mai robots.txt per nascondere una pagina dalla ricerca: usa invece il noindex (le pagine bloccate possono comunque comparire nella ricerca se ricevono link)
Tester del robots.txt
Google ha rimosso il tester del robots.txt da Search Console nel 2022. Puoi usare il tester del robots.txt autonomo oppure strumenti di terze parti.