robots.txtファイルは、検索エンジンのクローラーに、クロールを許可するページと許可しないページを伝えます。Google Search Consoleとの関係は次のとおりです。
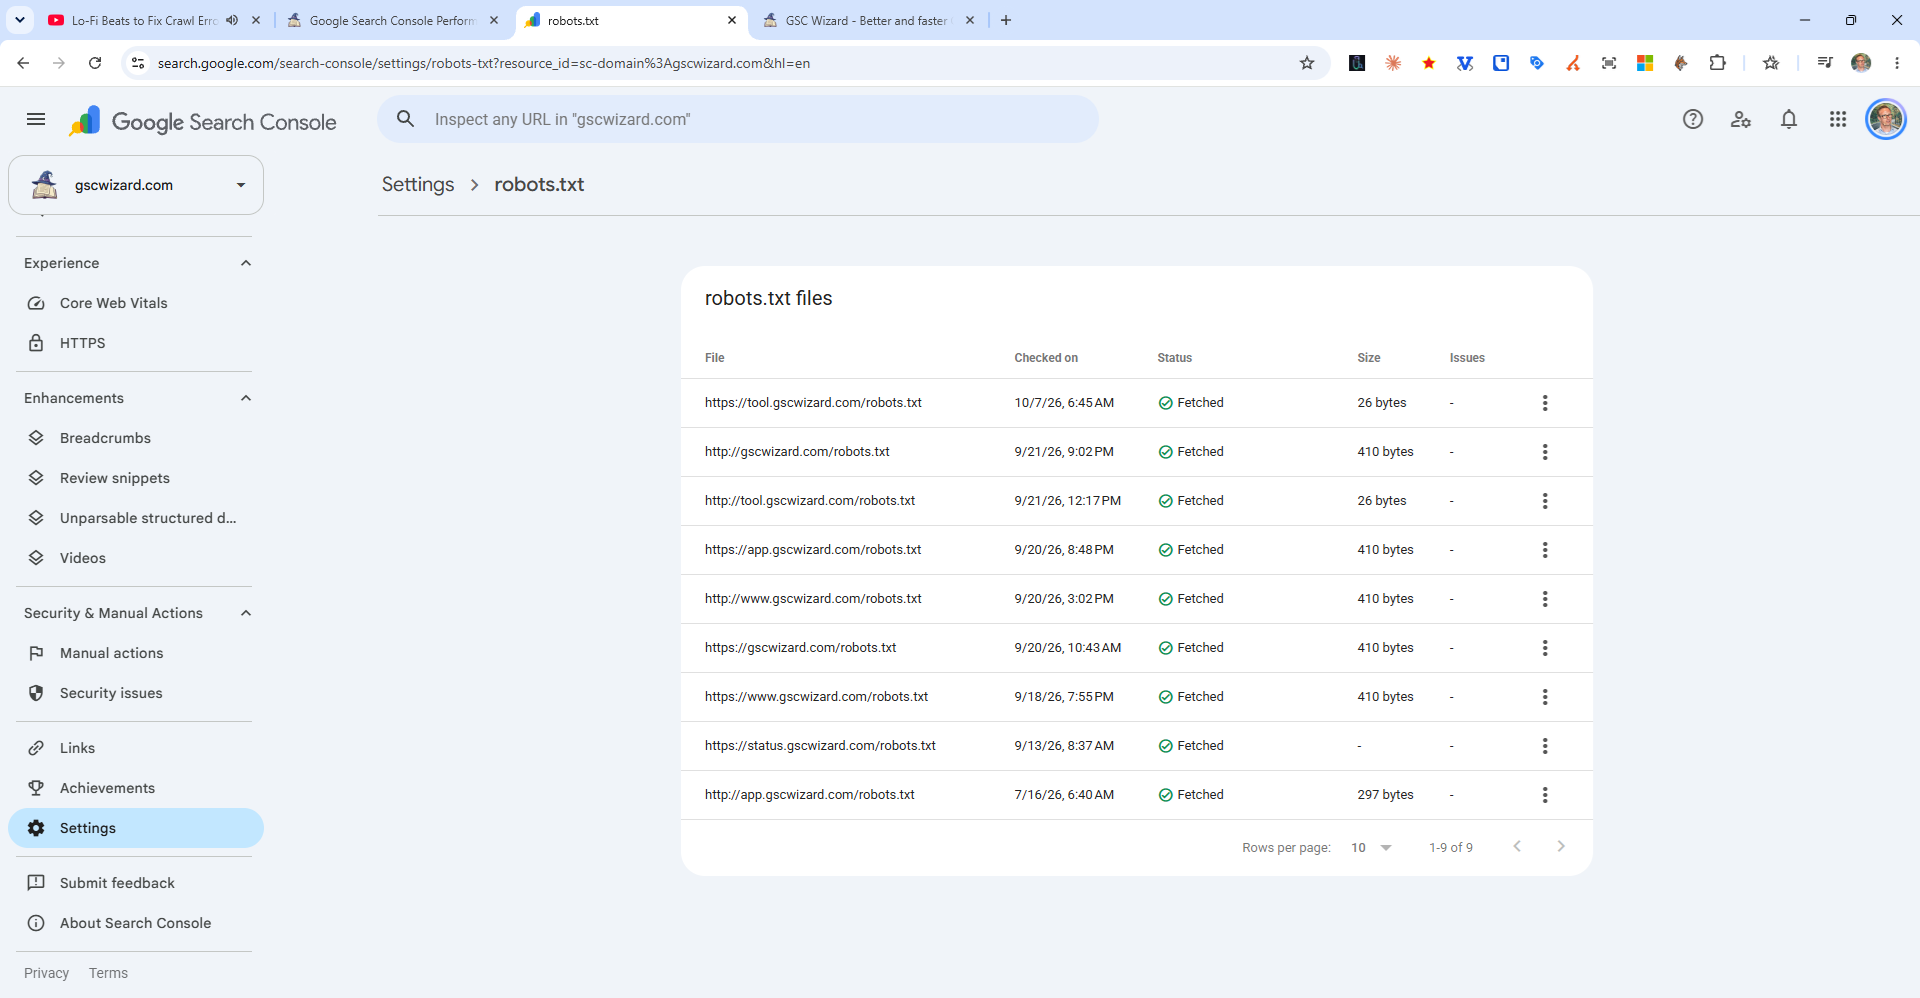
robots.txtの確認方法
ブラウザでhttps://yourdomain.com/robots.txtに直接アクセスします。プレーンテキストのファイルが表示されるはずです。
特定のページがブロックされていないか確認する
Search ConsoleのURL検査ツールを使います。ページが「robots.txtによってブロックされました」という状態かどうかは、クロールの詳細のセクションではっきり確認できます。
robots.txtのベストプラクティス
- インデックスさせたいページ(CSSやJSファイルを含む)はブロックしない
- 管理画面、ログインページ、サンクスページ、パラメータ違いの重複URLはブロックする
- サイトマップのURLをrobots.txtに記載する:
Sitemap: https://yourdomain.com/sitemap.xml - ページを検索結果から隠す目的でrobots.txtを使わない。代わりにnoindexを使う(ブロックしたページでも、リンクが張られていれば検索結果に表示されることがあります)
robots.txtテスター
Googleは2022年に、Search Consoleからrobots.txtテスターを削除しました。単体のrobots.txtテスターや、サードパーティのツールを利用できます。