Twój plik robots.txt mówi robotom wyszukiwarek, które strony mogą (lub nie mogą) skanować. Oto jak łączy się to z Google Search Console:
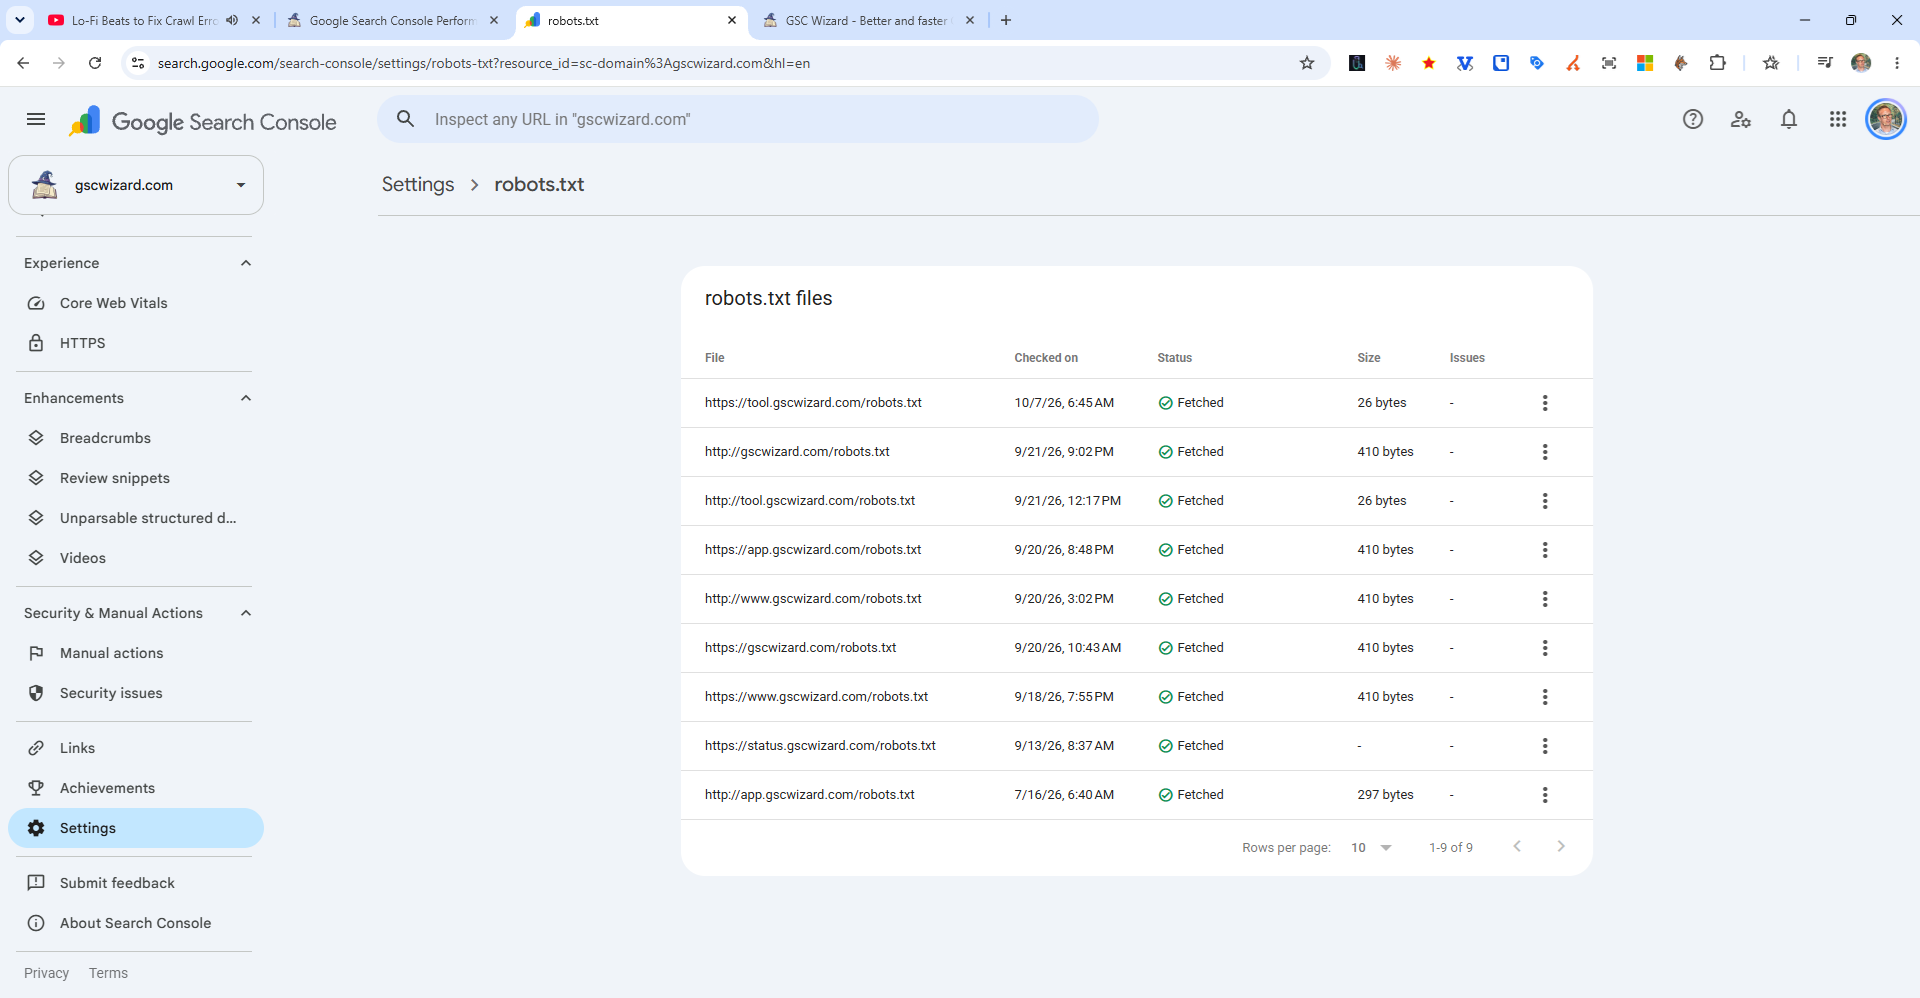
Sprawdzanie pliku robots.txt
Otwórz https://yourdomain.com/robots.txt bezpośrednio w przeglądarce. Powinieneś zobaczyć zwykły plik tekstowy.
Sprawdzanie, czy konkretna strona jest zablokowana
Użyj narzędzia do sprawdzania adresów URL w Search Console: w sekcji ze szczegółami skanowania pokaże ono wprost, czy strona jest „Zablokowana przez plik robots.txt”.
Dobre praktyki dla robots.txt
- NIE blokuj stron, które mają być zindeksowane (w tym plików CSS i JS)
- Blokuj panele administracyjne, strony logowania, strony z podziękowaniami i zduplikowane adresy z parametrami
- Podaj adres mapy witryny w robots.txt:
Sitemap: https://yourdomain.com/sitemap.xml - Nigdy nie używaj robots.txt do ukrywania strony w wyszukiwarce, użyj zamiast tego noindex (zablokowane strony mogą nadal pojawiać się w wynikach, jeśli prowadzą do nich linki)
Tester robots.txt
Google usunął tester robots.txt z Search Console w 2022 roku. Możesz użyć samodzielnego testera robots.txt albo narzędzi zewnętrznych.