Tu archivo robots.txt le dice a los rastreadores de los buscadores qué páginas pueden (o no pueden) rastrear. Así se relaciona con Google Search Console:
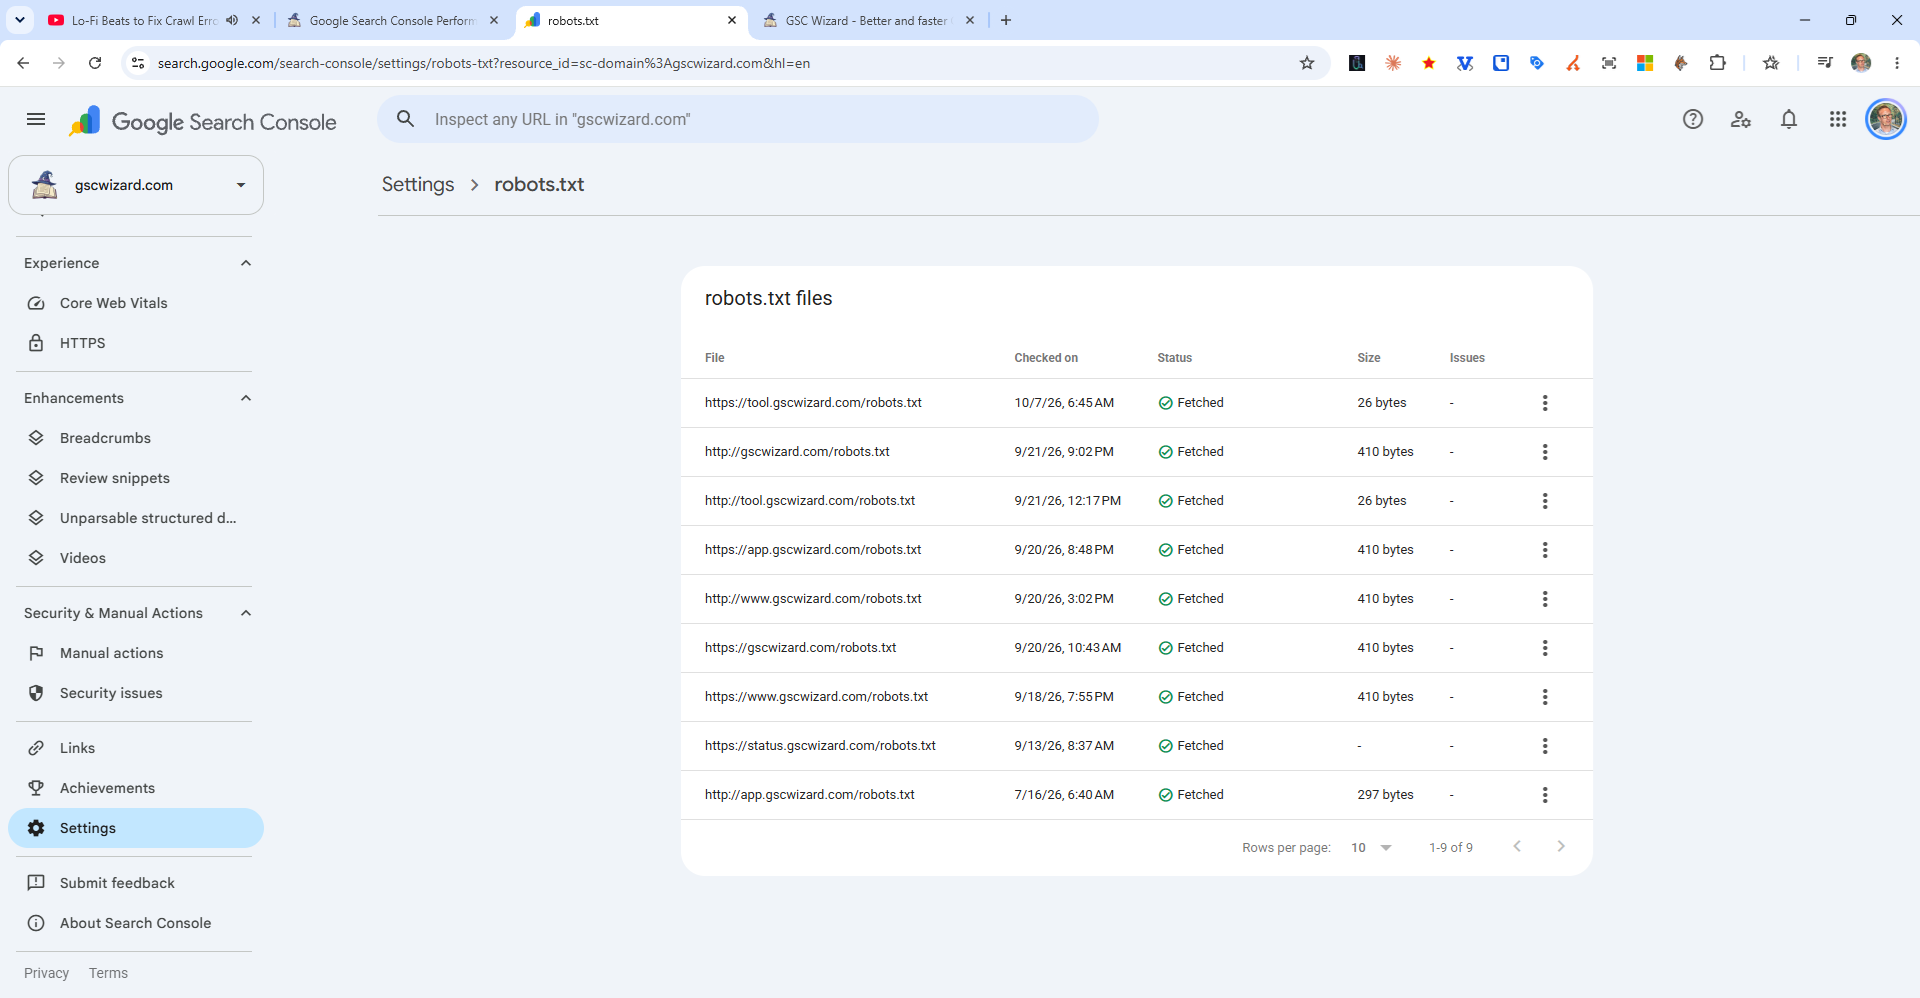
Cómo comprobar tu robots.txt
Visita https://yourdomain.com/robots.txt directamente en tu navegador. Deberías ver un archivo de texto plano.
Cómo comprobar si una página concreta está bloqueada
Usa la herramienta de inspección de URLs de Search Console: te indicará expresamente si una página está "Bloqueada por robots.txt" en la sección de detalles de rastreo.
Buenas prácticas para robots.txt
- NO bloquees las páginas que quieres que se indexen (incluidos los archivos CSS y JS)
- Bloquea los paneles de administración, las páginas de inicio de sesión, las páginas de agradecimiento y las URLs duplicadas por parámetros
- Indica la URL de tu sitemap en robots.txt:
Sitemap: https://yourdomain.com/sitemap.xml - Nunca uses robots.txt para ocultar una página de la búsqueda: usa noindex (las páginas bloqueadas aún pueden aparecer en la búsqueda si tienen enlaces apuntando a ellas)
Probador de robots.txt
Google eliminó el probador de robots.txt de Search Console en 2022. Puedes usar el probador de robots.txt independiente o herramientas de terceros.