Cómo posicionarte en Brave Search (y que Claude te cite)
Brave Search no rastrea ni posiciona las páginas como lo hace Google. Se apoya en personas reales que usan el navegador Brave para avalar una página antes incluso de que entre en el índice, y ese mismo índice proporciona la mayor parte de lo que cita Claude cuando responde con una búsqueda web. Así funciona realmente el mecanismo y qué hacer en lugar de pulsar "Submit URL" y esperar a ver qué pasa.
Consigue que el Web Discovery Project de Brave recoja páginas reales e indexables y, por extensión, que acaben entre lo que cita Claude.
20 minutos para auditar. Los resultados dependen del tráfico real, no de un formulario.
Acceso a robots.txt y a las reglas de bots del servidor o de la CDN, y algo de visibilidad ya existente en Google, Bing o DuckDuckGo.
Por qué "simplemente envía la URL" es un mal consejo
Un consejo que no deja de circular: Brave es el backend de búsqueda principal de Claude, Brave tiene una herramienta "Submit URL" en search.brave.com, así que si quieres que tu contenido aparezca antes en Claude, envía allí tus páginas importantes. Es una historia redonda, y engaña de una forma que puede costarte más de lo que ahorra.
La única función documentada de la herramienta es obligar a Brave a volver a descargar una URL que ya conoce. No es un envío al índice y no garantiza la indexación de contenido nuevo. Está pensada para "he arreglado algo, vuelve a mirarlo", no para "descubre esta página". Usada para lo primero, es inofensiva. Usada como estrategia de descubrimiento, es una palanca que no está conectada a nada.
El problema de fondo es lo que realmente permite que una página nueva entre en el índice de Brave, y no tiene nada que ver con un formulario.
Cómo encuentra Brave realmente las páginas nuevas: dos puertas, no una
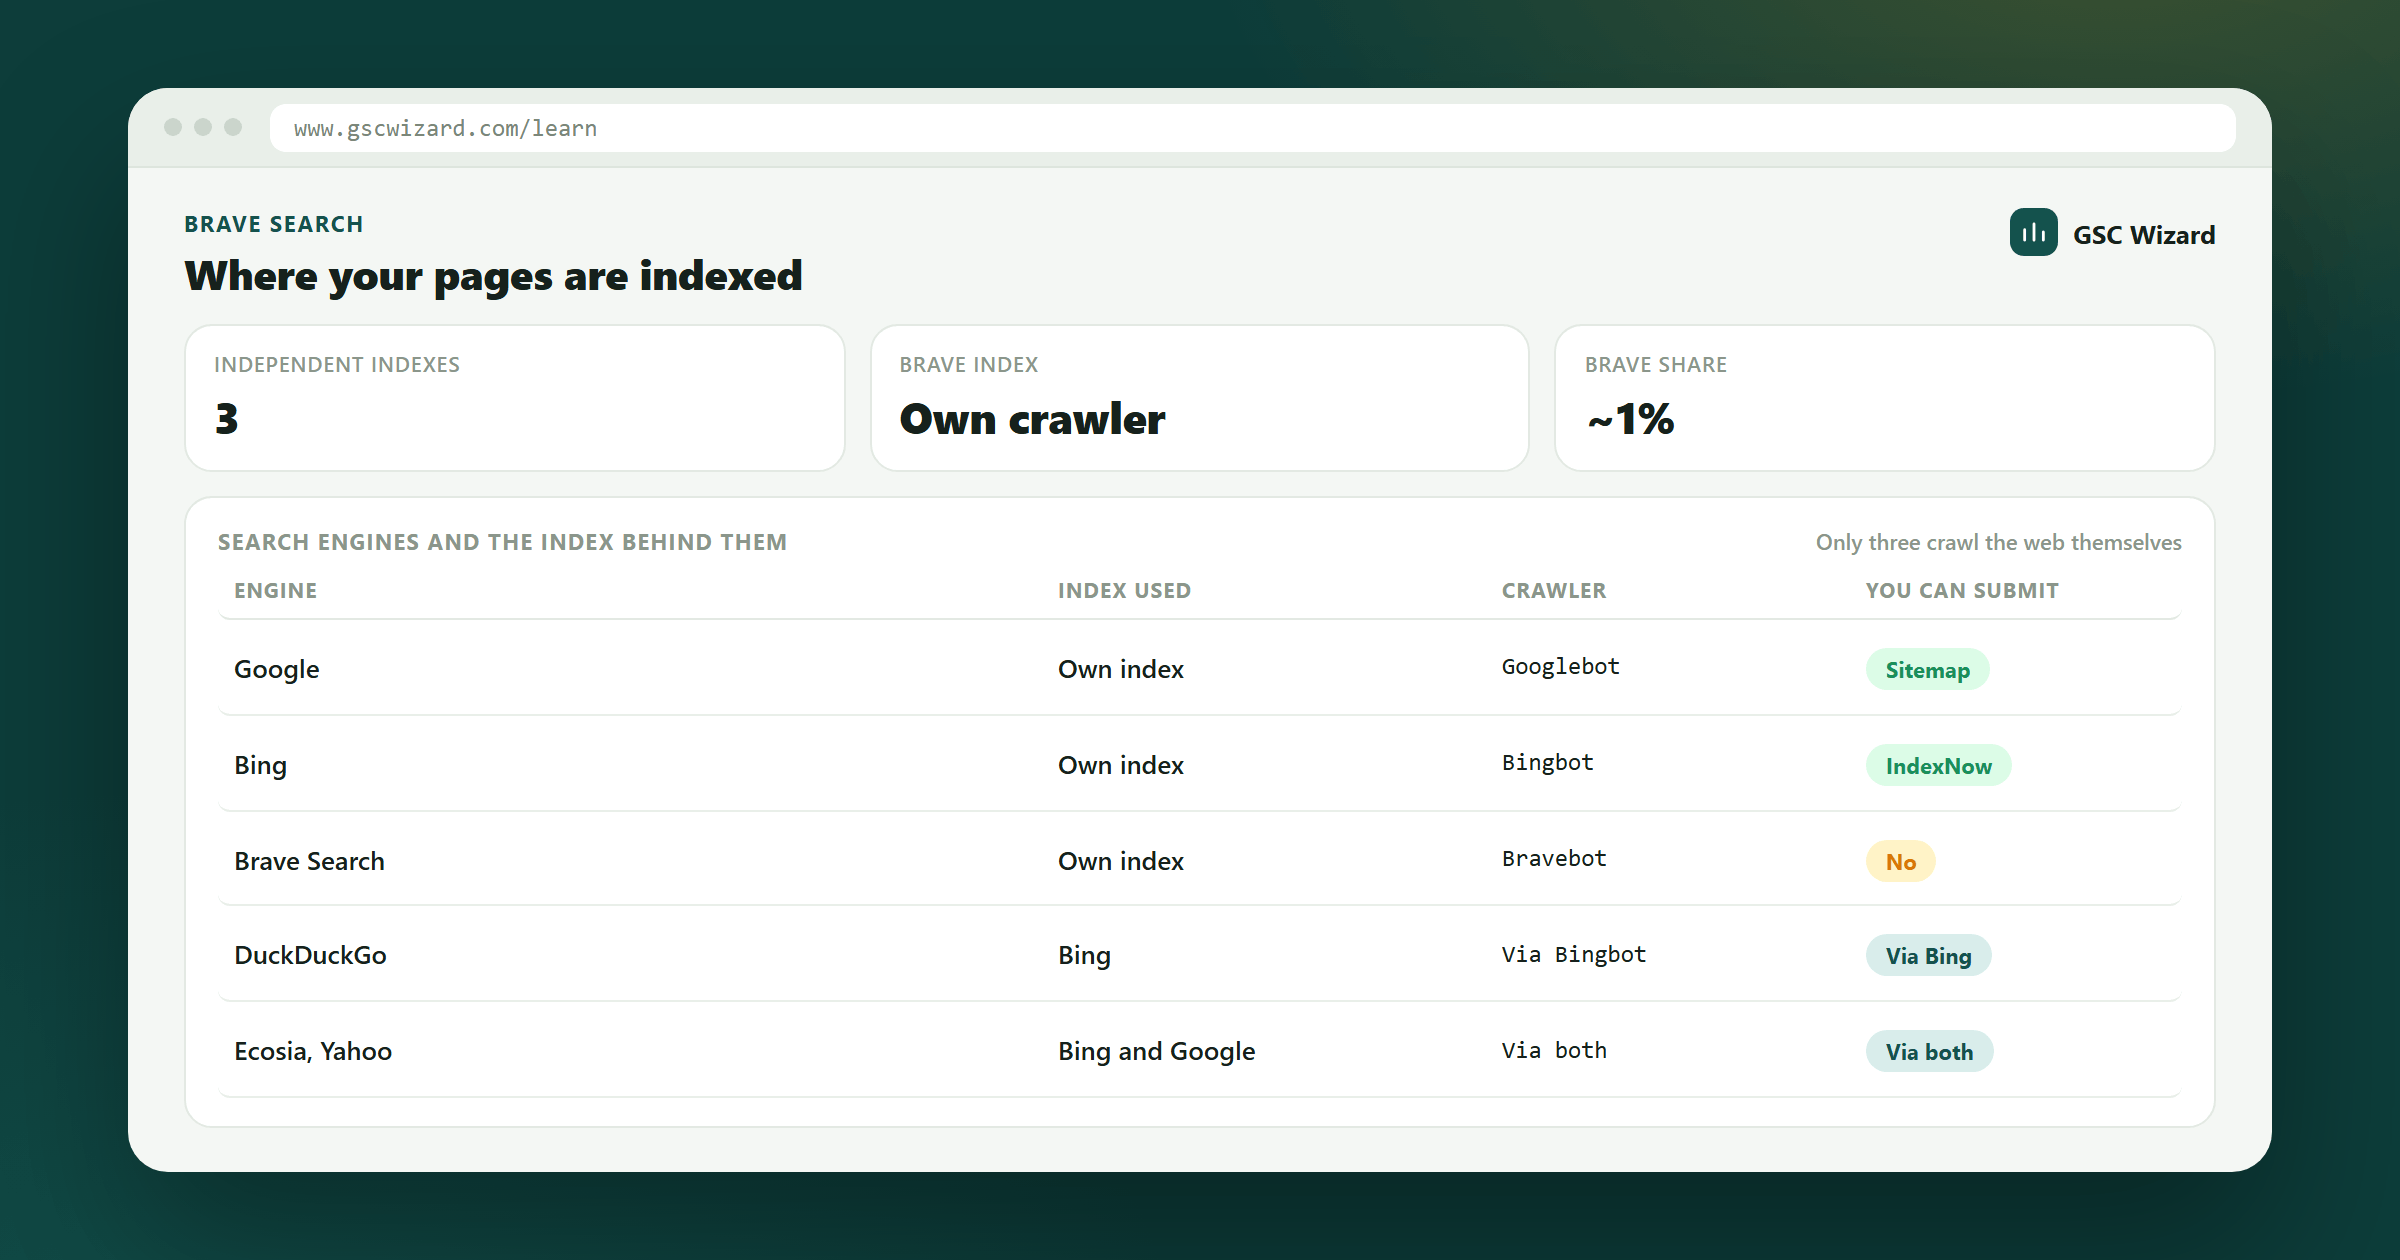
Brave no tiene una search console, ni envío de sitemaps, ni un equivalente a IndexNow. El descubrimiento se hace a través del Web Discovery Project (WDP), una función opcional del navegador Brave que informa de forma anónima de las páginas a las que llegan los usuarios que la han activado. El propio artículo del Centro de ayuda de Brave confirma que es estrictamente opcional y que los datos aportados "cannot be linked back to whoever contributed it". Se estima que unos 120 millones de personas forman parte de ese grupo. Si ninguna de ellas llega nunca a tu página, nada más de lo que hagas importa. Hay dos vías de entrada, con umbrales muy distintos.
Page Channel: la puerta difícil
Requiere que unos 20 usuarios distintos del WDP, desde redes diferentes, lleguen de forma independiente a la página. Las señales se protegen con el propio protocolo criptográfico STAR de Brave, que usa k-anonimato para que un valor solo se pueda leer cuando lo han enviado suficientes usuarios independientes. El documento de diseño de Brave describe el mecanismo pero no publica el quórum concreto; la cifra de unos 20 envíos para el propio Web Discovery Project procede de las pruebas independientes de MERJ que se mencionan más abajo. En cualquier caso, por debajo del umbral, los servidores de Brave literalmente no pueden descifrar ni reconstruir el contenido de la página: es un mecanismo de privacidad, no un filtro de spam arbitrario, pero el efecto práctico es el mismo: una página totalmente nueva y sin tráfico real puede permanecer invisible para Brave indefinidamente.
Query Channel: la puerta fácil
Solo requiere que un usuario con la función activada busque en Google, Bing, Yahoo o DuckDuckGo algo para lo que tu página ya se posiciona. El cliente de Brave reconoce la página de resultados, vuelve a descargar de forma anónima una versión depurada tras un retraso aleatorio de 1 a 20 minutos y extrae las URLs de ella, sin necesidad de un quórum de 20 personas.
La conclusión práctica: la forma más rápida de entrar en el índice de Brave suele ser posicionarse ya en otro sitio. Una página sin ninguna visibilidad en Google, Bing o DuckDuckGo tiene que superar el listón más alto de las 20 personas, que depende específicamente del tráfico orgánico de personas que usan el navegador Brave, una porción de tu audiencia total mucho menor que "cualquier visitante".
La lista técnica: asegúrate de que Brave pueda ver la página
Incluso cuando una página cumple los requisitos para ser descubierta, tiene que superar la verificación de "doble descarga" de Brave: una nueva descarga anónima y sin sesión iniciada que confirma que la página se ve igual para todo el mundo. Esa comprobación tiene reglas más estrictas que Googlebot:
- No se ejecuta JavaScript. El contenido que solo aparece después de un renderizado en el cliente es invisible para esta comprobación. Si una página depende de JS para su contenido principal, renderízala en el servidor o prerenderízala.
- Las redirecciones descalifican una página. Cualquier redirección en la cadena la marca como privada, incluso patrones de redirección que Google tolera sin problema.
- Límites de rendimiento estrictos. La descarga se aborta a los 10 segundos y rechaza respuestas de más de 2MB. Un time-to-first-byte lento o unas páginas demasiado pesadas fallan en silencio, sin ningún informe que te diga por qué.
- Solo cuentan las señales en el HTML. Un
noindexenviado mediante la cabecera HTTPX-Robots-Tagno se lee; solo se lee un<meta name="robots" content="noindex">en el<head>del HTML. Los canonicals solo se leen de un elemento<link rel="canonical">, nunca de una cabecera. Si tu CMS los define mediante cabeceras, la verificación de Brave puede estar viendo una página que no refleja en absoluto lo que pretendías. - Las query strings son arriesgadas sin un canonical. Un segundo parámetro, o una query string de más de unos 22 caracteres, marca la página como privada si no hay una etiqueta canonical explícita que apunte a una URL limpia.
- Ciertas palabras en la ruta resultan sospechosas. Las rutas que contienen palabras como
login,token,checkout,account,adminowp-adminse tratan con más recelo. Mantenlas fuera de las URLs canónicas de marketing.
No dejes que robots.txt bloquee a Bravebot en silencio
La propia página de ayuda del Search Crawler de Brave lo confirma directamente: "the Brave Search crawler does not advertise a differentiated user agent because we must avoid discrimination from websites that allow only Google to crawl them", y "if a domain or page is not crawlable by Googlebot, then Brave Search's bot will not crawl it either". En la práctica, eso significa que un patrón de seguridad habitual, "bloquear cualquier bot que no reconozcamos explícitamente" en robots.txt, o una regla de WAF/CDN que solo permite crawlers con nombre, puede excluir a Brave en silencio junto con todos los scrapers que pretendía frenar. No hay ningún mensaje de error; la página simplemente nunca se descarga. Revisa tu robots.txt en busca de un Disallow genérico y comprueba las reglas de bots del servidor o de la CDN (Cloudflare y WAFs similares son culpables habituales) antes de suponer que un problema de descubrimiento o de posicionamiento tiene que ver con la calidad del contenido.
Espera volatilidad, no estabilidad
El índice de Brave es muchísimo más pequeño que el de Google y parece dar mucho peso a las señales recientes; el propio Brave describe los datos subyacentes como imposibles de vincular a ningún usuario, dispositivo o sesión, que es un objetivo de diseño distinto de la estabilidad. En la práctica, varios SEOs que siguen Brave de cerca describen un patrón reconocible: una página es recogida, se posiciona bien durante unas semanas y luego cae igual de rápido, y a veces vuelve más tarde. Brave no ha publicado la mecánica exacta de esto, así que trátalo como un patrón observado y no documentado, pero es coherente con cómo suele comportarse un índice más pequeño y que prima la frescura. No reacciones a una oscilación de ranking en Brave como reaccionarías a un core update de Google. Considera las mejoras allí un extra además del tráfico real, no una métrica que defender semana a semana.
¿Deberías usar tú mismo el navegador Brave?
Es una táctica modesta y de coste realmente bajo que merece la pena considerar, pero no una estrategia a tiempo completo. Descargar Brave y activar el Web Discovery Project envía señales anónimas de navegación y de búsqueda que ayudan a construir el índice, y visitar tus propias páginas publicadas con la función activada puede ser una de las hasta 20 señales que necesita una página nueva, o la única señal que activa el Query Channel si buscas una consulta para la que la página ya se posiciona en otro sitio. No cambiará las cosas por sí sola y no sustituye a los visitantes reales, pero tampoco tiene ningún inconveniente real.
Por qué esto también decide si Claude te cita
Anthropic no ha confirmado la relación en un anuncio de producto, pero las divulgaciones de subencargados de su Trust Center nombran a Brave Search, y dos estudios independientes lo respaldan. El análisis original de Profound (marzo de 2025) encontró un solapamiento del 86,7 % entre las citas de Claude y los primeros resultados de Brave, estadísticamente muy por encima de la casualidad (p < 0,0001). Un estudio posterior de MERJ, más amplio, que abarcó unas 35.000 citas de Claude en 400 consultas (julio de 2026), llegó a un casi idéntico 79,2 % de las URLs que cita Claude situadas en el top 10 de Brave para la consulta correspondiente, frente a solo un 34 % en el top 10 de Google. La cobertura de Search Engine Land añade que Claude no parece reordenar los resultados de Brave, sino que los usa casi tal cual.
En la práctica, esto significa que todo lo anterior (que Brave pueda rastrearte, que cumplas los requisitos de la doble descarga, que estés realmente indexado y que te posiciones) es una palanca más directa para la visibilidad en Claude que cualquier cosa dirigida solo a Google. Si optimizas solo para Google, estás optimizando para el menor de los dos solapamientos.
La lista de comprobación
- Audita robots.txt y cualquier regla de WAF o de bots en busca de un bloqueo genérico que pueda estar excluyendo a Bravebot en silencio.
- Confirma que el contenido principal se renderiza en el servidor (no solo con JS), evita las cadenas de redirecciones y mantén las páginas muy por debajo de los límites de la doble descarga de 10 segundos y 2MB.
- Usa una etiqueta
<link rel="canonical">real, no solo una cabecera, y mantén las URLs canónicas libres de parámetros de consulta innecesarios. - Construye o confirma una visibilidad real en Google, Bing o DuckDuckGo. Esa es la puerta rápida del Query Channel hacia Brave.
- Si no hay un posicionamiento previo en el que apoyarte, céntrate en una promoción genuina que pueda llegar a usuarios del navegador Brave: construcción real de audiencia, no formularios de envío.
- Usa Submit URL solo después de una corrección real, para forzar una nueva revisión. No como mecanismo de descubrimiento.
- No te asustes por las oscilaciones de ranking a corto plazo en Brave. Tómate como señal la visibilidad sostenida, no el ruido de una semana a otra.
- Si quieres, usa tú mismo Brave con el Web Discovery Project activado. Cuesta poco y te convierte en una de tus propias señales.
Siguiente playbook
GSC Wizard no monitoriza Brave (ninguna consola de terceros lo hace todavía), pero los problemas de rastreabilidad que bloquean a Bravebot en silencio suelen afectar también a los usuarios reales y a otros bots. Empieza por diagnosticar problemas técnicos de indexación → en tu propio sitio, que cubre los problemas de robots.txt y de canonical que importan para todos los buscadores, no solo para Google.
Escrito por Jan-Willem Bobbink · Publicado el 28 de agosto de 2026