Jak rankować w Brave Search (i być cytowanym przez Claude)
Brave Search nie crawluje i nie rankuje stron tak jak Google. Opiera się na prawdziwych ludziach używających przeglądarki Brave, którzy poświadczają stronę, zanim w ogóle trafi do indeksu, a ten sam indeks dostarcza większość tego, co Claude cytuje, gdy odpowiada z użyciem wyszukiwania w sieci. Oto jak ten mechanizm naprawdę działa i co robić zamiast klikać „Submit URL” i liczyć na szczęście.
Spraw, by prawdziwe, indeksowalne strony zostały zauważone przez Web Discovery Project Brave, a tym samym trafiły do tego, co cytuje Claude.
20 minut na audyt. Wyniki zależą od prawdziwego ruchu, a nie od formularza.
Dostęp do pliku robots.txt oraz reguł botów na serwerze lub w CDN i pewna istniejąca widoczność w Google, Bing lub DuckDuckGo.
Dlaczego rada „po prostu zgłoś adres URL” jest zła
Rada, która wciąż krąży: Brave jest głównym silnikiem wyszukiwania dla Claude, Brave ma narzędzie „Submit URL” na search.brave.com, więc jeśli chcesz, by Twoje treści szybciej pojawiały się w Claude, zgłoś tam ważne strony. To zgrabna historia i wprowadza w błąd w sposób, który może kosztować więcej, niż oszczędza.
Jedyna udokumentowana funkcja tego narzędzia to wymuszenie ponownego pobrania przez Brave adresu URL, który już zna. To nie jest zgłoszenie do indeksu i nie gwarantuje zindeksowania nowej treści. Zbudowano je pod „coś poprawiłem, spójrz jeszcze raz”, a nie „odkryj tę stronę”. Traktowane jak to pierwsze, jest nieszkodliwe. Traktowane jak strategia odkrywania, jest dźwignią, która do niczego nie jest podłączona.
Większym problemem jest to, co w ogóle decyduje o wpuszczeniu nowej strony do indeksu Brave, i nie ma to nic wspólnego z formularzem.
Jak Brave naprawdę znajduje nowe strony: dwoje drzwi, nie jedne
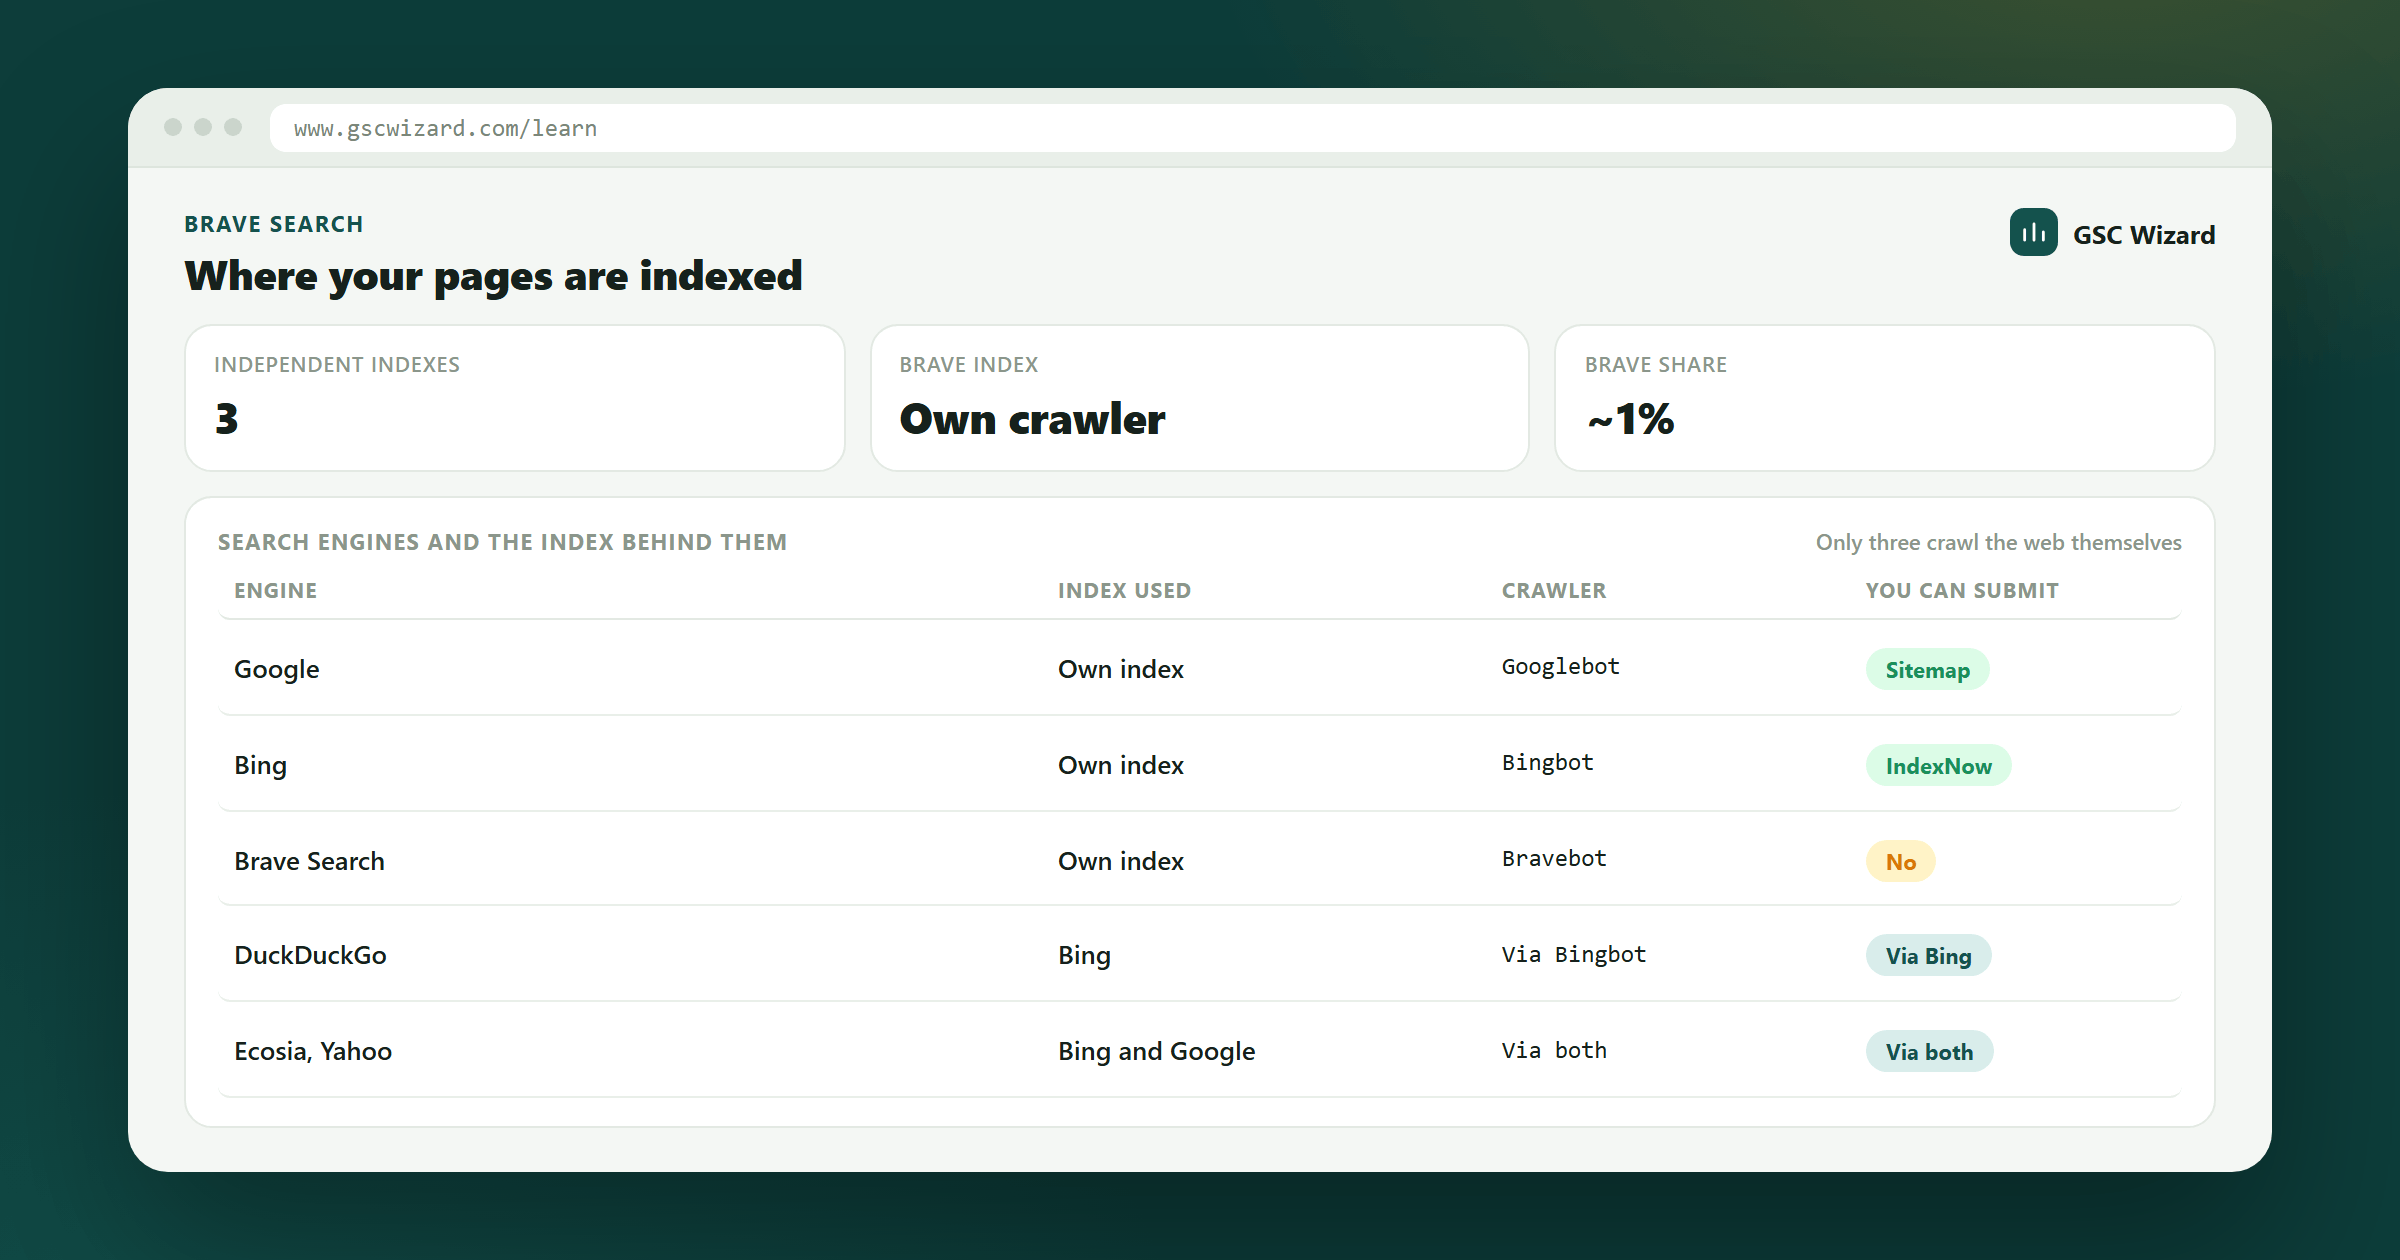
Brave nie ma odpowiednika Search Console, zgłaszania map witryn ani IndexNow. Odkrywanie odbywa się przez Web Discovery Project (WDP), dobrowolną funkcję przeglądarki Brave, która anonimowo zgłasza, na jakie strony trafiają użytkownicy, którzy się na nią zgodzili. Artykuł w Centrum pomocy Brave potwierdza, że jest to wyłącznie opt-in, a przekazane dane „nie mogą zostać powiązane z osobą, która je przekazała”. Szacuje się, że w tej puli jest około 120 milionów osób. Jeśli żadna z nich nigdy nie trafi na Twoją stronę, nic innego nie ma znaczenia. Są dwie drogi wejścia, z bardzo różnymi progami.
Page Channel: trudne drzwi
Wymaga, by niezależnie na stronę trafiło mniej więcej 20 różnych użytkowników WDP, którzy się na nią zgodzili, z różnych sieci. Sygnały są chronione własnym protokołem kryptograficznym STAR Brave, który wykorzystuje k-anonimowość, więc wartość staje się czytelna dopiero wtedy, gdy przekaże ją wystarczająca liczba niezależnych użytkowników. Opis projektu Brave tłumaczy mechanizm, ale nie podaje konkretnego kworum; wartość około 20 udostępnień dla samego Web Discovery Project pochodzi z niezależnych testów MERJ, opisanych niżej. Tak czy inaczej, poniżej progu serwery Brave dosłownie nie potrafią odszyfrować ani odtworzyć zawartości strony. To mechanizm prywatności, a nie dowolny filtr antyspamowy, ale praktyczny skutek jest ten sam: zupełnie nowa strona bez realnego ruchu może pozostawać niewidoczna dla Brave w nieskończoność.
Query Channel: łatwe drzwi
Wymaga tylko jednego użytkownika, który się zgodził i który szuka w Google, Bing, Yahoo lub DuckDuckGo frazy, na którą Twoja strona już rankuje. Klient Brave rozpoznaje stronę wyników, anonimowo pobiera ponownie jej oczyszczoną wersję po losowym opóźnieniu od 1 do 20 minut i wyciąga z niej adresy URL, bez kworum 20 osób.
Praktyczny wniosek: najszybszą drogą do indeksu Brave jest zwykle to, że strona już gdzie indziej rankuje. Strona bez żadnej widoczności w Google, Bing lub DuckDuckGo musi pokonać trudniejszą poprzeczkę 20 osób, która zależy konkretnie od ruchu organicznego od ludzi używających przeglądarki Brave, czyli mniejszej części Twojej publiczności niż „każdy odwiedzający”.
Lista kontrolna techniczna: upewnij się, że Brave w ogóle widzi stronę
Nawet gdy strona kwalifikuje się do odkrycia, musi przejść weryfikację „double-fetch” w Brave: anonimowe pobranie bez zalogowania, które potwierdza, że strona wygląda tak samo dla wszystkich. Ta kontrola ma surowsze zasady niż Googlebot:
- JavaScript nie jest wykonywany. Treść, która pojawia się dopiero po renderowaniu po stronie klienta, jest dla tej kontroli niewidoczna. Jeśli strona zależy od JS w kwestii głównej treści, renderuj ją po stronie serwera lub wstępnie.
- Przekierowania dyskwalifikują stronę. Każde przekierowanie w łańcuchu oznacza ją jako prywatną, nawet wzorce przekierowań, które Google toleruje bez problemu.
- Surowe limity wydajności. Pobranie przerywa się po 10 sekundach i odrzuca odpowiedzi powyżej 2MB. Wolny czas do pierwszego bajtu lub rozdęte strony odpadają po cichu, bez żadnego raportu z wyjaśnieniem.
- Liczą się tylko sygnały w HTML. Dyrektywa
noindexwysłana w nagłówku HTTPX-Robots-Tagnie jest odczytywana, tylko<meta name="robots" content="noindex">w HTML w sekcji<head>. Adresy canonical są odczytywane wyłącznie z elementu<link rel="canonical">, nigdy z nagłówka. Jeśli Twój CMS ustawia je przez nagłówki, weryfikacja Brave może widzieć stronę, która w ogóle nie odzwierciedla Twoich intencji. - Ciągi zapytania są ryzykowne bez canonical. Drugi parametr zapytania albo ciąg zapytania dłuższy niż około 22 znaki oznacza stronę jako prywatną, jeśli nie ma jawnego tagu canonical wskazującego czysty adres.
- Niektóre słowa w ścieżce wyglądają ryzykownie. Ścieżki zawierające słowa takie jak
login,token,checkout,account,adminczywp-admintraktowane są z większą podejrzliwością. Nie umieszczaj ich w kanonicznych adresach marketingowych.
Nie pozwól, by robots.txt po cichu blokował Bravebota
Strona pomocy Search Crawler samego Brave potwierdza to wprost: „crawler Brave Search nie ogłasza odrębnego user agenta, ponieważ musimy unikać dyskryminacji ze strony witryn, które zezwalają na crawlowanie tylko Google”, oraz „jeśli domena lub strona nie jest crawlowalna dla Googlebota, bot Brave Search również jej nie przeskanuje”. W praktyce oznacza to, że popularny wzorzec bezpieczeństwa, czyli „blokuj każdego bota, którego wyraźnie nie rozpoznajemy” w robots.txt albo reguła WAF/CDN dopuszczająca tylko wymienionych crawlerów, może po cichu wykluczyć Brave razem z każdym scraperem, który miał być zatrzymany. Nie ma komunikatu o błędzie; strona po prostu nigdy nie zostaje pobrana. Sprawdź robots.txt pod kątem ogólnego Disallow oraz reguł botów na poziomie serwera lub CDN (częstymi winowajcami są Cloudflare i podobne WAF-y), zanim uznasz, że problem z odkrywaniem lub pozycjami dotyczy jakości treści.
Spodziewaj się zmienności, nie stabilności
Indeks Brave jest dramatycznie mniejszy niż indeks Google i wydaje się silnie ważyć świeże sygnały. Sam Brave opisuje dane źródłowe jako niepowiązywalne z żadnym użytkownikiem, urządzeniem ani sesją, co jest innym celem projektowym niż stabilność. W praktyce kilku specjalistów SEO, którzy uważnie śledzą Brave, opisuje rozpoznawalny schemat: strona zostaje zauważona, rankuje dobrze przez kilka tygodni, po czym równie szybko spada, a czasem wraca później. Brave nie opublikował dokładnej mechaniki tego zjawiska, więc traktuj to jako obserwowany wzorzec, a nie udokumentowany, ale pasuje on do zachowania mniejszego indeksu ważonego świeżością. Nie reaguj na wahania pozycji w Brave tak, jak reagowałbyś na core update Google. Traktuj tamtejsze zyski jako bonus ponad realny ruch, a nie metrykę do obrony z tygodnia na tydzień.
Czy powinieneś sam używać przeglądarki Brave?
To skromna, naprawdę tania taktyka, którą warto rozważyć, ale nie strategia na pełny etat. Pobranie Brave i zgoda na Web Discovery Project wysyła anonimowe sygnały przeglądania i wyszukiwania, które pomagają budować indeks, a odwiedzanie własnych opublikowanych stron z włączoną zgodą może być jednym z maksymalnie 20 sygnałów potrzebnych nowej stronie albo tym jednym sygnałem, który uruchamia Query Channel, jeśli wyszukasz frazę, na którą strona już gdzie indziej rankuje. Samo w sobie nie zmieni sytuacji i nie zastąpi prawdziwych odwiedzających, ale nie ma też realnej wady w jego używaniu.
Dlaczego to decyduje też o tym, czy Claude Cię zacytuje
Anthropic nie potwierdził tej relacji w ogłoszeniu produktowym, ale własne ujawnienia podwykonawców w Trust Center wymieniają Brave Search, a dwa niezależne badania to potwierdzają. Pierwotna analiza Profound (marzec 2025) wykazała 86,7% zbieżności między cytowaniami Claude a najwyższymi wynikami Brave, statystycznie daleko poza przypadkiem (p < 0,0001). Większe badanie uzupełniające MERJ, obejmujące około 35 000 cytowań Claude dla 400 zapytań (lipiec 2026), pokazało niemal identyczne 79,2% adresów URL cytowanych przez Claude znajdujących się w top 10 Brave dla odpowiadającego zapytania, wobec zaledwie 34% w top 10 Google. Relacja w Search Engine Land dodaje, że Claude najwyraźniej nie zmienia kolejności wyników Brave, tylko wykorzystuje je prawie bez zmian.
W praktyce oznacza to, że wszystko powyżej, czyli crawlowalność przez Brave, kwalifikowalność do double-fetch, faktyczne zindeksowanie i pozycje, jest bardziej bezpośrednią dźwignią widoczności w Claude niż cokolwiek skierowane wyłącznie do Google. Jeśli optymalizujesz tylko pod Google, optymalizujesz pod mniejszą z dwóch części wspólnych.
Lista kontrolna
- Sprawdź robots.txt i wszelkie reguły WAF/botów pod kątem ogólnej blokady, która mogłaby po cichu wykluczać Bravebota.
- Upewnij się, że główna treść jest renderowana po stronie serwera (a nie tylko w JS), unikaj łańcuchów przekierowań i utrzymuj strony wyraźnie poniżej limitów double-fetch: 10 sekund i 2MB.
- Użyj prawdziwego tagu
<link rel="canonical">, a nie tylko nagłówka, i trzymaj adresy canonical wolne od zbędnych parametrów zapytania. - Zbuduj lub potwierdź realną widoczność w Google, Bing lub DuckDuckGo. To szybkie drzwi Query Channel do Brave.
- Jeśli nie ma istniejących pozycji, na których można się oprzeć, skup się na prawdziwej promocji, która może dotrzeć do użytkowników przeglądarki Brave: budowaniu realnej publiczności, a nie formularzach zgłoszeniowych.
- Używaj Submit URL tylko po realnej poprawce, aby wymusić ponowne spojrzenie. Nie jako mechanizmu odkrywania.
- Nie panikuj z powodu krótkoterminowych wahań pozycji w Brave. Sygnałem jest utrzymująca się widoczność, a nie tygodniowy szum.
- Opcjonalnie sam używaj Brave z włączonym Web Discovery Project. Kosztuje niewiele, a sprawia, że stajesz się jednym z własnych sygnałów.
Następny poradnik
GSC Wizard nie śledzi Brave (żadna zewnętrzna konsola jeszcze tego nie robi), ale problemy ze skanowaniem, które po cichu blokują Bravebota, zwykle dotykają też prawdziwych użytkowników i inne boty. Zacznij od diagnozowania technicznych problemów z indeksowaniem → na własnej witrynie; obejmuje to problemy z robots.txt i canonicalami, które mają znaczenie dla każdej wyszukiwarki, nie tylko dla Google.
Autor: Jan-Willem Bobbink · Opublikowano 28 sierpnia 2026