Brave Searchで上位表示する方法(そしてClaudeに引用される方法)
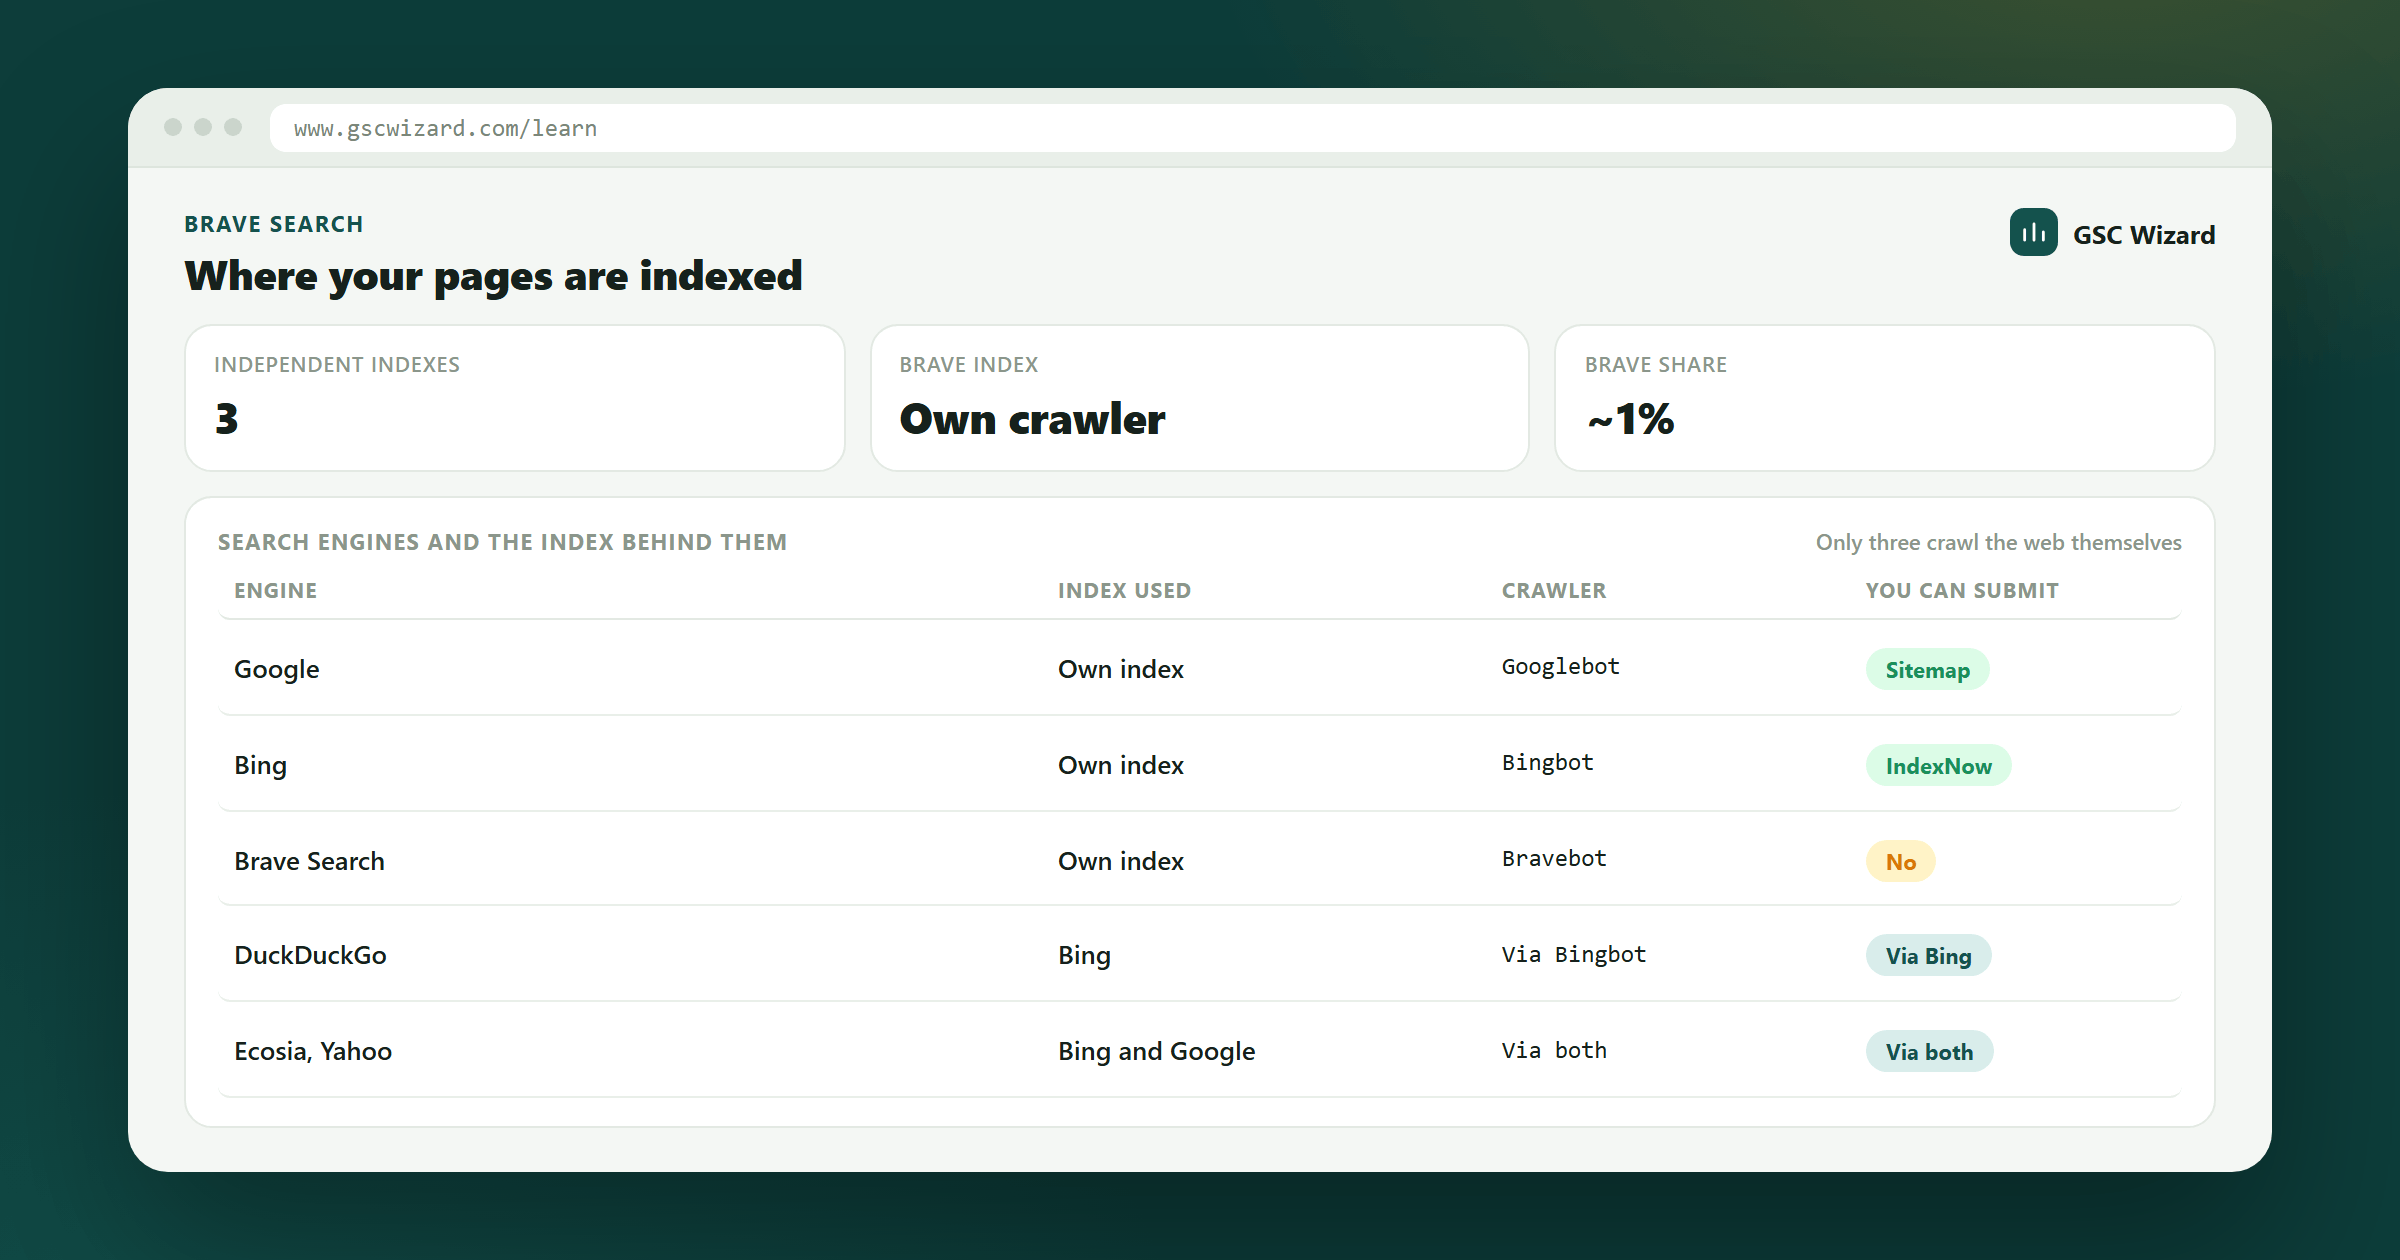
Brave Searchは、Googleのようにページをクロールして順位付けするわけではありません。ページがインデックスに入る前から、Braveブラウザを使う実在の人々がそのページを保証することに頼っており、そのインデックスが、Claudeがウェブ検索で回答するときに引用する情報の大半を供給しています。ここでは、その仕組みが実際にどう動くのかと、「Submit URL」を押して祈る代わりに何をすべきかを説明します。
実在するインデックス可能なページをBraveのWeb Discovery Projectに拾ってもらい、ひいてはClaudeが引用する情報に入れる。
監査に20分。結果はフォームではなく、実際のトラフィックで決まります。
robots.txt / サーバーまたはCDNのボットルールへのアクセスと、Google、Bing、DuckDuckGoですでにある程度の可視性があること。
「URLを送信するだけ」が悪いアドバイスである理由
こんな話が出回っています。BraveはClaudeの主要な検索バックエンドで、Braveにはsearch.brave.comに「Submit URL」ツールがあるので、コンテンツをClaudeに早く表示させたければ、重要なページをそこから送信すればよい、と。もっともらしい話ですが、得られるものより失うもののほうが大きくなりかねない誤解を招く話です。
このツールで文書化されている唯一の機能は、Braveがすでに知っているURLを再取得させることです。インデックスへの送信ではなく、新しいコンテンツのインデックス登録を保証するものでもありません。「何かを直したのでもう一度見てください」のためのもので、「このページを見つけてください」のためのものではありません。前者として扱うなら無害ですが、発見の戦略として扱うなら、何にもつながっていないレバーです。
さらに大きな問題は、新しいページが最初にBraveのインデックスに入れるかどうかを実際に左右するものが、フォームとは何の関係もないことです。
Braveが新しいページを見つける方法:入口は1つではなく2つ
Braveにはsearch consoleも、サイトマップの送信も、IndexNowに相当するものもありません。発見はWeb Discovery Project(WDP)を通じて行われます。これはBraveブラウザのオプトイン機能で、オプトインしたユーザーが訪れたページを匿名で報告します。Brave自身のヘルプセンターの記事は、これが完全にオプトインであり、提供されたデータは「提供者に結び付けることはできない」と確認しています。そのプールには約1億2,000万人がいると推定されています。そのうち誰一人としてあなたのページにたどり着かなければ、ほかに何をしても意味がありません。入口は2つあり、しきい値は大きく異なります。
ページチャネル:厳しい入口
異なるネットワークから、オプトインしたWDPユーザー約20人が、それぞれ独立してそのページにたどり着く必要があります。シグナルはBrave独自のSTAR暗号プロトコルで保護されており、k-匿名性を用いて、十分な数の独立したユーザーが送信して初めて値が読み取れるようになります。Braveの設計に関する解説はこの仕組みを説明していますが、具体的な定足数は公表していません。Web Discovery Project自体の「約20共有」という数字は、以下のMERJの独立したテストによるものです。いずれにせよ、しきい値を下回ると、Braveのサーバーはページの内容を復号することも再構成することも、文字どおりできません。これはスパムフィルターのような恣意的なものではなくプライバシーの仕組みですが、実際の影響は同じです。実際のトラフィックがない新しいページは、Braveからいつまでも見えないままになりかねません。
クエリチャネル:簡単な入口
オプトインしたユーザーが1人、あなたのページがすでに上位にあるGoogle、Bing、Yahoo、DuckDuckGoで検索するだけで足ります。Braveのクライアントは検索結果ページを認識し、1〜20分のランダムな遅延の後にそのページのクリーンなバージョンを匿名で再取得して、そこからURLを取り出します。20人という定足数は必要ありません。
実践的な結論:Braveのインデックスに入る最も早い方法は、たいていすでに別の場所で上位表示されていることです。Google、Bing、DuckDuckGoでの可視性がゼロのページは、より厳しい20人の基準を満たす必要があり、それはBraveブラウザを使っている人からのオーガニックトラフィックに特に依存します。これは「あらゆる訪問者」に比べて、全体のオーディエンスのごく一部です。
技術チェックリスト:Braveがそもそもページを見られるようにする
ページが発見の対象になったとしても、Braveの「ダブルフェッチ」検証を通過する必要があります。これは、ページが誰にとっても同じに見えることを確認する、匿名でログアウト状態の再取得です。このチェックには、Googlebotよりも厳しいルールがあります。
- JavaScriptは実行されません。クライアントサイドのレンダリング後にしか表示されないコンテンツは、このチェックでは見えません。主要コンテンツをJSに依存しているページは、サーバーサイドレンダリングまたはプリレンダリングしてください。
- リダイレクトがあるとページは失格になります。チェーンのどこかにリダイレクトがあると、そのページは非公開とみなされます。Googleなら問題なく許容するリダイレクトのパターンでも同様です。
- 厳しいパフォーマンス制限があります。取得は10秒で打ち切られ、2MBを超えるレスポンスは拒否されます。TTFBが遅い、あるいはページが重いと、理由を知らせるレポートもなく、黙って失敗します。
- HTMLのシグナルだけが有効です。
X-Robots-TagHTTPヘッダーで送られたnoindexは読み取られず、HTMLの<head>内にある<meta name="robots" content="noindex">だけが有効です。canonicalも、<link rel="canonical">要素からのみ読み取られ、ヘッダーからは読み取られません。CMSがこれらをヘッダーで設定していると、Braveの検証は、あなたの意図とまったく異なるページを見ている可能性があります。 - canonicalがないクエリ文字列はリスクがあります。2つ目のクエリパラメータ、または約22文字を超えるクエリ文字列があり、クリーンなURLを指す明示的なcanonicalタグがない場合、そのページは非公開とみなされます。
- 特定のパスの語は怪しく見えます。
login、token、checkout、account、admin、wp-adminなどの語を含むパスは、より疑わしく扱われます。これらは、canonicalのマーケティング用URLに含めないでください。
robots.txtでBravebotを黙ってブロックしない
Brave自身のSearch Crawlerのヘルプページが、はっきり認めています。「Brave Searchのクローラーは、Googleにしかクロールを許可しないウェブサイトからの差別を避ける必要があるため、区別されたユーザーエージェントを公開していません」「ドメインやページがGooglebotでクロールできない場合、Brave Searchのボットもクロールしません」。実際には、robots.txtでの「明示的に認識していないボットはすべてブロックする」という一般的なセキュリティの手法や、名前を挙げたクローラーだけを許可リストに入れるWAF/CDNのルールは、止めたかったスクレイパーと一緒にBraveも黙って締め出してしまうということです。エラーメッセージは出ず、ページがただ取得されません。発見やランキングの問題がコンテンツの品質にあると考える前に、robots.txtに包括的なDisallowがないか、サーバーやCDNレベルのボットルール(CloudflareなどのWAFがよくある原因です)を確認してください。
安定ではなく、変動を覚悟する
Braveのインデックスは、Googleより格段に小さく、最近のシグナルを重く見ているようです。Brave自身も、基になるデータはどのユーザー、デバイス、セッションにも結び付けられないと説明しており、これは安定性とは異なる設計目標です。実際には、Braveを注視している複数のSEO担当者が、あるパターンを報告しています。ページが拾われ、数週間は上位に表示され、その後同じくらい急に消え、ときに戻ってくることもあるというものです。Braveはこの正確な仕組みを公表していないので、文書化された事実ではなく観察されたパターンとして扱ってください。ただし、より小さく新しさを重視するインデックスの挙動とは一致しています。Braveの順位の変動に、Googleのコアアップデートのように反応してはいけません。そこでの上昇は、実際のトラフィックに上乗せされるボーナスと考え、毎週守るべき指標とは考えないでください。
自分でもBraveブラウザを使うべきですか?
ささやかでコストがほとんどかからない施策なので検討する価値はありますが、フルタイムの戦略というほどではありません。Braveをダウンロードし、Web Discovery Projectにオプトインすると、インデックスの構築に役立つ匿名の閲覧・検索シグナルが送られます。オプトインした状態で自分の公開ページを訪れることは、新しいページに必要な最大20のシグナルのうちの1つになったり、そのページがすでに別の場所で上位表示されているクエリを検索すれば、クエリチャネルを動かす唯一のシグナルになったりすることがあります。それだけで状況が変わることはなく、実際の訪問者の代わりにもなりませんが、実行して実質的なデメリットもありません。
これがClaudeに引用されるかどうかも左右する理由
Anthropicは製品発表でこの関係を確認していませんが、自身のTrust Centerのサブプロセッサー開示にBrave Searchが挙げられており、2つの独立した調査がそれを裏付けています。Profoundの最初の分析(2025年3月)では、Claudeの引用とBraveの上位結果との重複が86.7%あり、偶然をはるかに超える統計的有意性(p < 0.0001)がありました。400のクエリにわたる約35,000件のClaudeの引用を対象とした、より大規模な追跡調査であるMERJの調査(2026年7月)でも、ほぼ同じ結果になりました。Claudeが引用するURLの79.2%が、対応するクエリでBraveの上位10件に入っていたのに対し、Googleの上位10件ではわずか34%でした。Search Engine Landの報道によれば、ClaudeはBraveの結果を再ランク付けしているようには見えず、ほぼそのまま使っています。
実際には、上記のすべて、つまりBraveにクロールされ、ダブルフェッチの対象となり、実際にインデックス登録され、上位に表示されることが、Googleだけを狙ったどんな施策よりも、Claudeでの可視性に直接効くレバーになります。Googleだけに最適化するのは、2つの重なりのうち小さいほうに最適化していることになります。
チェックリスト
- robots.txtとWAF/ボットのルールを監査し、Bravebotを黙って除外しているかもしれない包括的なブロックがないか確認する。
- 主要なコンテンツがサーバーサイドでレンダリングされていること(JSのみではないこと)を確認し、リダイレクトチェーンを避け、ページをダブルフェッチの制限である10秒 / 2MBよりも十分に小さく保つ。
- ヘッダーだけでなく、実際の
<link rel="canonical">タグを使い、canonical URLに不要なクエリパラメータを含めない。 - Google、Bing、DuckDuckGoでの実際の順位の可視性を築く、または確認する。それがBraveへの高速なクエリチャネルの入口です。
- 頼れる既存の順位がない場合は、本物のプロモーションに注力する。Braveのブラウザユーザーに届く、実際のオーディエンス作りです。送信フォームではありません。
- Submit URLは、実際の修正の後にだけ使う、新たに見てもらうために。発見の仕組みとしては使わない。
- Braveの短期的な順位変動に慌てないでください。週ごとのノイズではなく、継続的な表示状況をシグナルとして見ましょう。
- 必要に応じて、ご自身でもWeb Discovery Projectを有効にしてBraveを使ってみてください。コストは低く、自分自身もシグナルの一部になれます。
次のプレイブック
GSC WizardはBraveを追跡していません(サードパーティのコンソールでも、まだ対応しているものはありません)が、Bravebotを静かにブロックしてしまうクロール可能性の問題は、たいてい実際のユーザーや他のボットにも影響します。まずはご自身のサイトで技術的なインデックス登録の問題を診断する →から始めてください。Googleだけでなく、あらゆる検索エンジンに関わるrobots.txtとcanonicalの問題を扱っています。
執筆:Jan-Willem Bobbink · 公開:2026年8月28日