Come posizionarsi su Brave Search (e farsi citare da Claude)
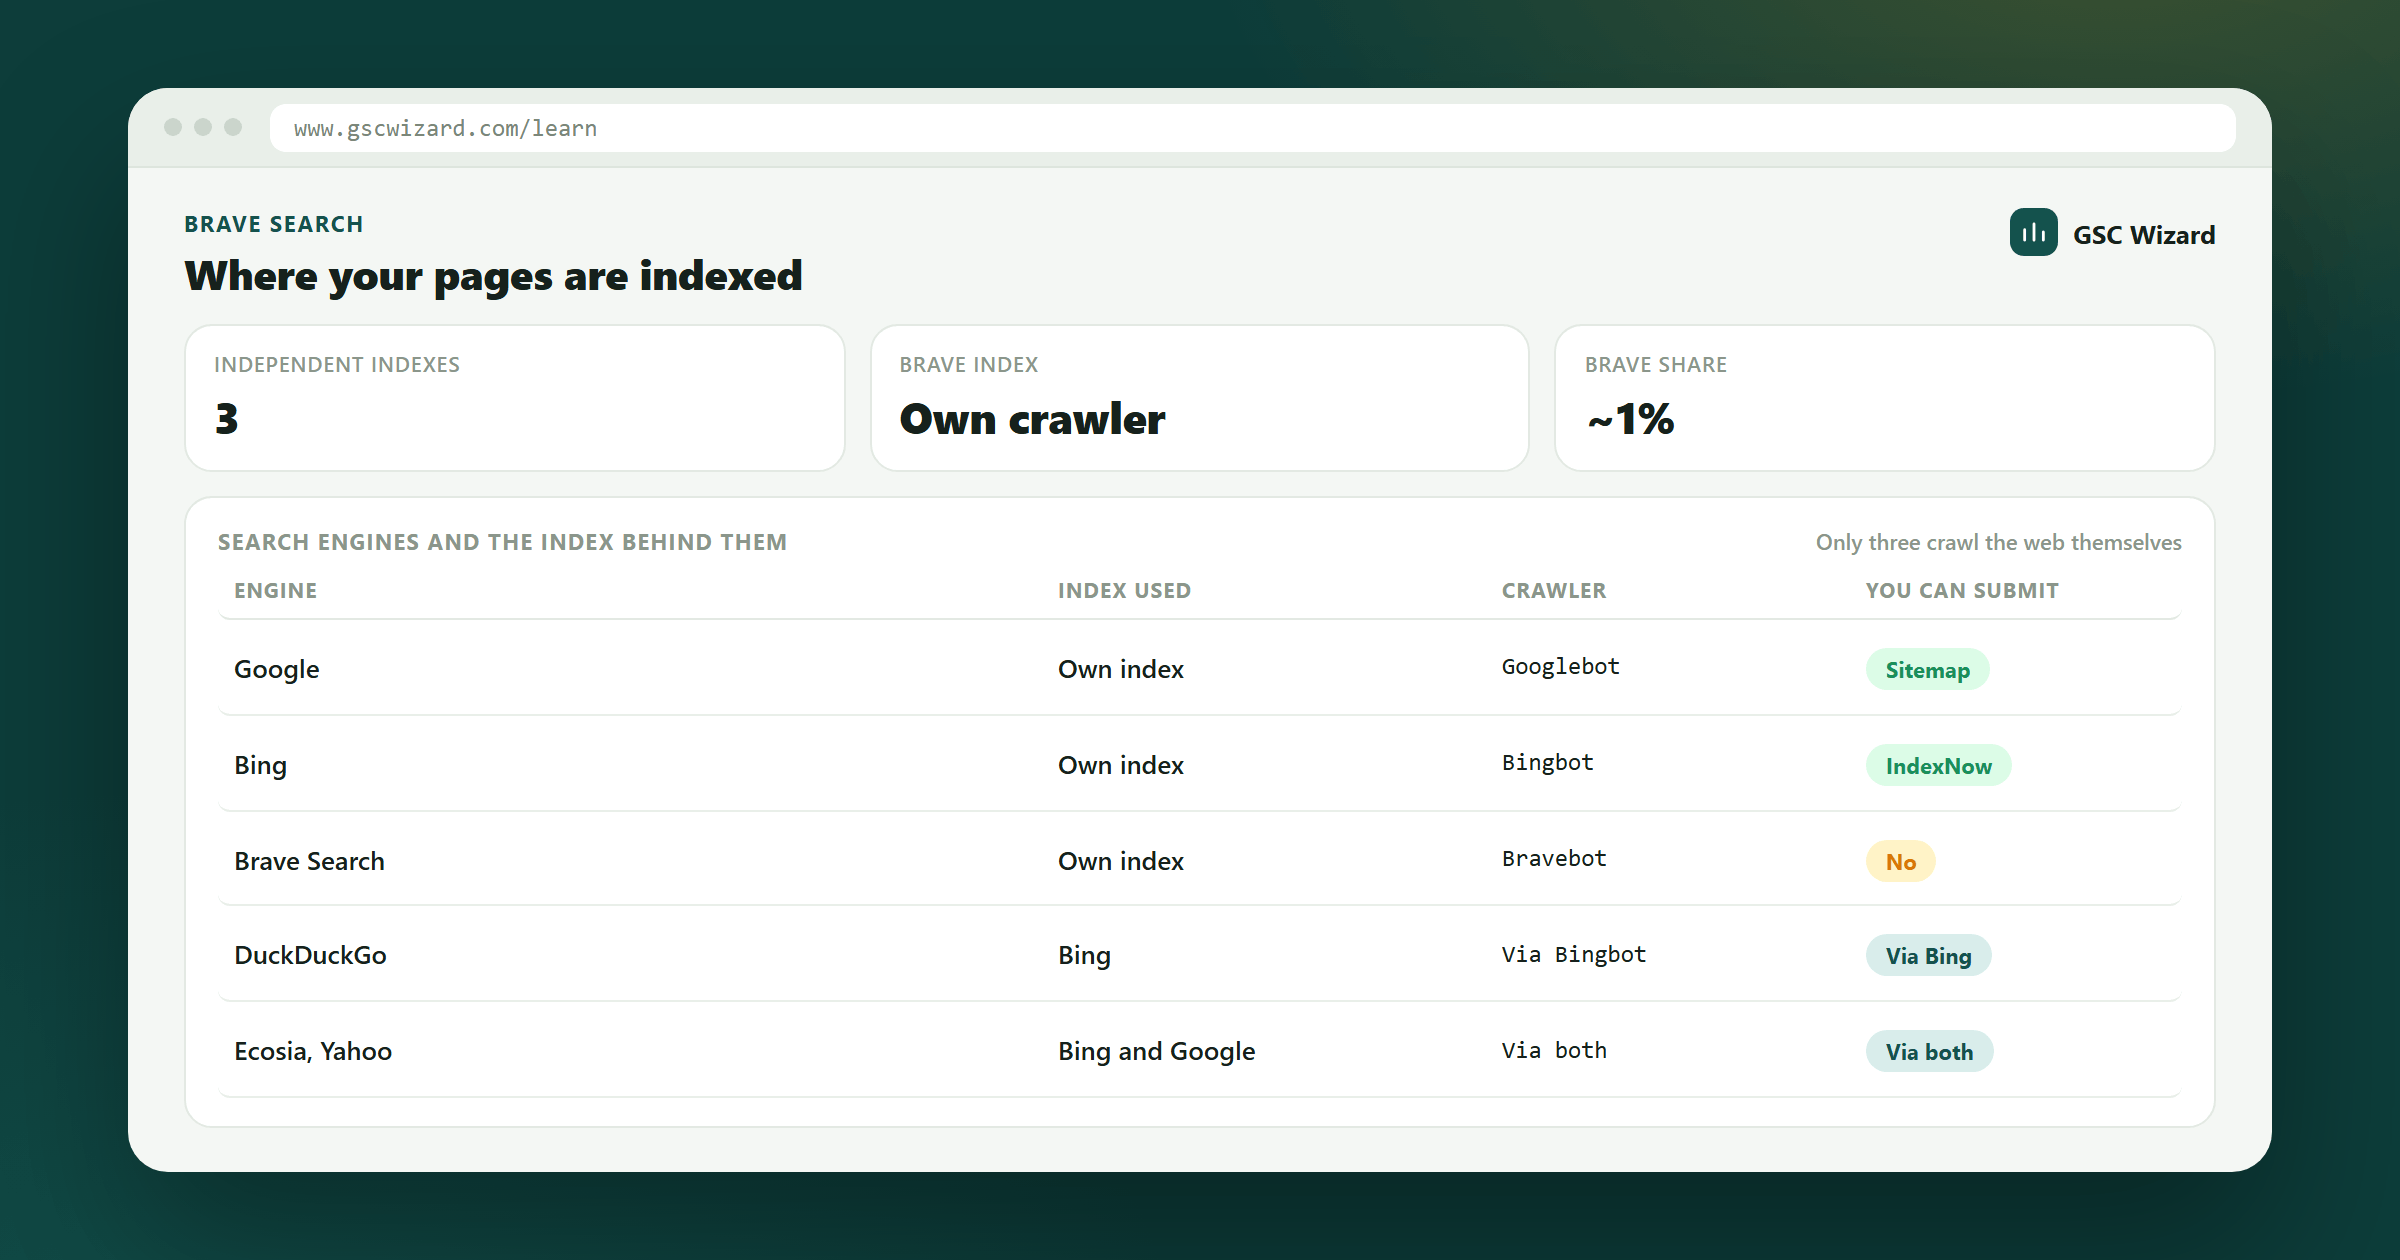
Brave Search non scansiona e posiziona le pagine come fa Google. Si affida a persone reali che usano il browser Brave per garantire per una pagina ancora prima che entri nell'indice, e quello stesso indice fornisce la maggior parte di ciò che Claude cita quando risponde con una ricerca web. Ecco come funziona davvero il meccanismo e cosa fare invece di premere “Submit URL” e sperare.
Far rilevare pagine reali e indicizzabili dal Web Discovery Project di Brave, e di conseguenza farle entrare tra ciò che Claude cita.
20 minuti per l'audit. I risultati dipendono dal traffico reale, non da un modulo.
Accesso a robots.txt e alle regole dei bot del server o della CDN, e un po' di visibilità già esistente su Google, Bing o DuckDuckGo.
Perché “basta inviare l'URL” è un cattivo consiglio
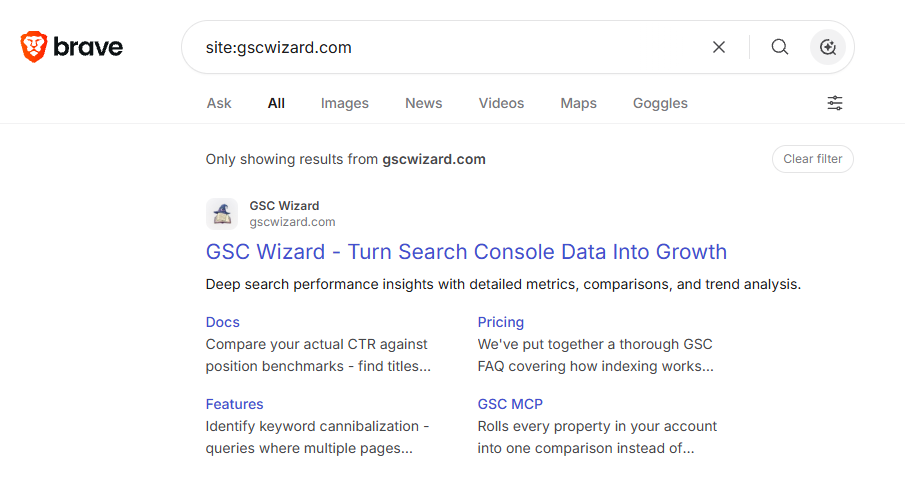
Un consiglio che continua a circolare: Brave è il backend di ricerca principale di Claude, Brave ha uno strumento “Submit URL” su search.brave.com, quindi se vuoi che i tuoi contenuti compaiano più in fretta in Claude, invia lì le tue pagine importanti. È una storia ordinata, ed è fuorviante in un modo che può costarti più di quanto ti faccia risparmiare.
L'unica funzione documentata dello strumento è costringere Brave a rieseguire il fetch di un URL che già conosce. Non è un invio all'indice e non garantisce l'indicizzazione di contenuti nuovi. È pensato per il caso “ho sistemato qualcosa, guarda di nuovo”, non per “scopri questa pagina”. Usato come il primo, è innocuo. Usato come strategia di scoperta, è una leva che non è collegata a niente.
Il problema più grande è ciò che in primo luogo fa entrare una nuova pagina nell'indice di Brave, e non ha nulla a che vedere con un modulo.
Come Brave trova davvero le nuove pagine: due porte, non una
Brave non ha una search console, né l'invio di sitemap, né un equivalente di IndexNow. La scoperta passa attraverso il Web Discovery Project (WDP), una funzione facoltativa del browser Brave che segnala in forma anonima le pagine su cui arrivano gli utenti che l'hanno attivata. L'articolo del Centro assistenza di Brave conferma che è rigorosamente opt-in e che i dati contribuiti “non possono essere ricollegati a chi li ha forniti”. Si stima che in quel gruppo ci siano circa 120 milioni di persone. Se nessuna di loro arriva mai sulla tua pagina, nient'altro di ciò che fai conta. Ci sono due strade d'ingresso, con soglie molto diverse.
Page Channel: la porta difficile
Richiede che circa 20 utenti WDP diversi che hanno attivato la funzione, da reti diverse, arrivino in modo indipendente sulla pagina. I segnali sono protetti dal protocollo crittografico STAR di Brave, che usa la k-anonimità, per cui un valore diventa leggibile solo quando un numero sufficiente di utenti indipendenti lo ha inviato. La descrizione del progetto di Brave illustra il meccanismo ma non pubblica il quorum preciso; la cifra di circa 20 invii per il Web Discovery Project stesso deriva dai test indipendenti di MERJ riportati più sotto. In ogni caso, sotto la soglia i server di Brave letteralmente non possono decifrare né ricostruire il contenuto della pagina: è un meccanismo di privacy, non un filtro antispam arbitrario, ma l'effetto pratico è lo stesso: una pagina nuova di zecca senza traffico reale può restare invisibile a Brave a tempo indeterminato.
Query Channel: la porta facile
Richiede soltanto un utente con la funzione attiva che cerchi su Google, Bing, Yahoo o DuckDuckGo una query per cui la tua pagina è già posizionata. Il client di Brave riconosce la pagina dei risultati, ne recupera in forma anonima una versione ripulita dopo un ritardo casuale da 1 a 20 minuti ed estrae da lì gli URL: nessun quorum di 20 persone.
La conclusione pratica: il modo più rapido per entrare nell'indice di Brave è di solito essere già posizionati altrove. Una pagina senza alcuna visibilità su Google, Bing o DuckDuckGo deve superare la soglia più difficile dei 20 utenti, che dipende specificamente dal traffico organico di persone che usano il browser Brave, una fetta del tuo pubblico totale più piccola di “qualsiasi visitatore”.
La checklist tecnica: assicurati che Brave possa almeno vedere la pagina
Anche quando una pagina si qualifica per la scoperta, deve superare la verifica “double-fetch” di Brave: un nuovo fetch anonimo, senza login, che conferma che la pagina appaia uguale a tutti. Questo controllo ha regole più severe di Googlebot:
- Non viene eseguito alcun JavaScript. I contenuti che compaiono solo dopo un rendering lato client sono invisibili a questo controllo. Se una pagina dipende da JS per il contenuto principale, usa il rendering lato server o il pre-rendering.
- I redirect squalificano una pagina. Qualsiasi redirect nella catena la segna come privata, anche con schemi di redirect che Google tollera senza problemi.
- Limiti di prestazioni rigidi. Il fetch si interrompe dopo 10 secondi e rifiuta risposte superiori a 2MB. Un time-to-first-byte lento o pagine troppo pesanti falliscono in silenzio, senza alcun report che ti dica perché.
- Contano solo i segnali nell'HTML. Un
noindexinviato tramite l'header HTTPX-Robots-Tagnon viene letto: conta solo un<meta name="robots" content="noindex">nel<head>dell'HTML. I canonical vengono letti solo da un elemento<link rel="canonical">, mai da un header. Se il tuo CMS li imposta tramite header, la verifica di Brave potrebbe guardare una pagina che non riflette affatto le tue intenzioni. - Le query string sono rischiose senza un canonical. Un secondo parametro di query, o una query string di oltre circa 22 caratteri, segna la pagina come privata se non c'è un tag canonical esplicito che punti a un URL pulito.
- Alcune parole nei percorsi sembrano rischiose. I percorsi che contengono parole come
login,token,checkout,account,adminowp-adminvengono trattati con maggiore sospetto. Tienile fuori dagli URL canonici di marketing.
Non lasciare che robots.txt blocchi Bravebot in silenzio
La pagina di aiuto sul crawler di Brave Search lo conferma direttamente: “il crawler di Brave Search non dichiara uno user agent differenziato perché dobbiamo evitare discriminazioni da parte dei siti che consentono la scansione solo a Google”, e “se un dominio o una pagina non è scansionabile da Googlebot, nemmeno il bot di Brave Search lo scansionerà”. In pratica significa che uno schema di sicurezza molto diffuso, “blocca qualsiasi bot che non riconosciamo esplicitamente” in robots.txt, oppure una regola WAF/CDN che mette in allowlist solo i crawler indicati per nome, può escludere in silenzio Brave insieme a ogni scraper che si voleva fermare. Non c'è alcun messaggio di errore: la pagina semplicemente non viene mai recuperata. Controlla il tuo robots.txt per un Disallow generico e le regole sui bot a livello di server o CDN (Cloudflare e WAF simili sono colpevoli frequenti) prima di dare per scontato che un problema di scoperta o di ranking riguardi la qualità dei contenuti.
Aspettati volatilità, non stabilità
L'indice di Brave è enormemente più piccolo di quello di Google e sembra dare molto peso ai segnali recenti: Brave stesso descrive i dati sottostanti come non riconducibili a nessun utente, dispositivo o sessione, un obiettivo di progettazione diverso dalla stabilità. In pratica, diversi SEO che monitorano Brave da vicino riferiscono uno schema riconoscibile: una pagina viene rilevata, si posiziona bene per qualche settimana, poi crolla altrettanto in fretta, a volte tornando su più tardi. Brave non ha pubblicato i dettagli esatti di questo meccanismo, quindi consideralo uno schema osservato e non documentato, ma è coerente con il comportamento tipico di un indice più piccolo e pesato sulla freschezza. Non reagire a un'oscillazione di ranking su Brave come reagiresti a un core update di Google. Considera i guadagni lì come un bonus che si aggiunge al traffico reale, non come una metrica da difendere settimana dopo settimana.
Dovresti usare tu stesso il browser Brave?
È una tattica modesta e davvero a basso costo che vale la pena considerare, ma non una strategia a tempo pieno. Scaricare Brave e attivare il Web Discovery Project invia segnali anonimi di navigazione e ricerca che contribuiscono a costruire l'indice, e visitare le tue pagine pubblicate con la funzione attiva può essere uno dei fino a 20 segnali di cui una nuova pagina ha bisogno, oppure il singolo segnale che attiva il Query Channel se cerchi una query per cui la pagina è già posizionata altrove. Da solo non cambierà le cose e non sostituisce i visitatori reali, ma non c'è nemmeno un vero svantaggio nell'usarlo.
Perché questo decide anche se Claude ti cita
Anthropic non ha confermato il rapporto in un annuncio di prodotto, ma le informative sui sub-responsabili del Trust Center dell'azienda nominano Brave Search, e due studi indipendenti lo confermano. L'analisi originale di Profound (marzo 2025) ha trovato una sovrapposizione dell'86,7% tra le citazioni di Claude e i primi risultati di Brave, statisticamente ben oltre il caso (p < 0,0001). Un successivo studio MERJ più ampio, su circa 35.000 citazioni di Claude relative a 400 query (luglio 2026), è arrivato a un 79,2% quasi identico di URL citati da Claude presenti nella top 10 di Brave per la query corrispondente, contro appena il 34% per la top 10 di Google. La copertura di Search Engine Land aggiunge che Claude non sembra riordinare i risultati di Brave, ma li usa quasi così come sono.
In pratica, significa che tutto quanto sopra, cioè essere scansionabili da Brave, idonei al double-fetch, effettivamente indicizzati e posizionati, è una leva più diretta per la visibilità su Claude di qualsiasi cosa rivolta solo a Google. Se ottimizzi solo per Google, stai ottimizzando per la più piccola delle due sovrapposizioni.
La checklist
- Verifica robots.txt e le eventuali regole WAF/bot alla ricerca di un blocco generico che potrebbe escludere Bravebot in silenzio.
- Verifica che il contenuto principale sia renderizzato lato server (non solo JS), evita le catene di redirect e mantieni le pagine ben sotto i limiti del double-fetch di 10 secondi / 2MB.
- Usa un vero tag
<link rel="canonical">, non solo un header, e mantieni gli URL canonici privi di parametri di query superflui. - Costruisci o verifica una reale visibilità di ranking su Google, Bing o DuckDuckGo. È la porta veloce del Query Channel verso Brave.
- Se non c'è un ranking esistente su cui contare, concentrati su una promozione autentica che possa raggiungere gli utenti del browser Brave: costruzione di un pubblico vero, non moduli di invio.
- Usa Submit URL solo dopo una correzione reale, per forzare una nuova scansione. Non come meccanismo di scoperta.
- Niente panico per le oscillazioni di ranking a breve termine su Brave. Considera segnale la visibilità costante, non il rumore da una settimana all'altra.
- Se vuoi, usa tu stesso Brave con il Web Discovery Project attivo. Costa poco e ti rende uno dei tuoi stessi segnali.
Prossimo playbook
GSC Wizard non monitora Brave (nessuna console di terze parti lo fa ancora), ma i problemi di crawlability che bloccano in silenzio Bravebot di solito riguardano anche gli utenti reali e gli altri bot. Parti da come diagnosticare i problemi tecnici di indicizzazione → sul tuo sito: copre i problemi di robots.txt e canonical che contano per ogni motore, non solo per Google.
Scritto da Jan-Willem Bobbink · Pubblicato il 28 agosto 2026