Brave Search'te nasıl sıralanılır (ve Claude tarafından nasıl alıntılanılır)
Brave Search, sayfaları Google'ın yaptığı gibi taramaz ve sıralamaz. Bir sayfa dizine girmeden önce bile, o sayfanın güvenilirliğine Brave tarayıcısını kullanan gerçek insanların tanıklık etmesine dayanır; aynı dizin, Claude bir web aramasıyla yanıt verirken alıntıladığı kaynakların çoğunu da sağlar. Mekanizmanın gerçekte nasıl çalıştığı ve "Submit URL" düğmesine basıp ummak yerine neler yapılması gerektiği burada.
Gerçek, dizine eklenebilir sayfaların Brave'in Web Discovery Project'i tarafından fark edilmesini ve dolayısıyla Claude'un alıntıladığı kaynaklar arasına girmesini sağlayın.
Denetim için 20 dakika. Sonuçlar bir forma değil, gerçek trafiğe bağlıdır.
robots.txt ile sunucu veya CDN bot kurallarına erişim ve Google, Bing ya da DuckDuckGo'da mevcut bir miktar görünürlük.
"URL'yi gönderin yeter" neden kötü bir tavsiye
Sürekli dolaşan bir ipucu: Brave, Claude'un birincil arama altyapısıdır ve search.brave.com adresinde bir "Submit URL" aracı vardır; bu yüzden içeriğinizin Claude'da daha hızlı görünmesini istiyorsanız önemli sayfalarınızı oraya gönderin. Derli toplu bir hikâye, ama kazandırdığından fazlasına mal olabilecek şekilde yanıltıcı.
Aracın belgelenmiş tek işlevi, Brave'i zaten bildiği bir URL'yi yeniden çekmeye zorlamaktır. Dizine bir gönderim değildir ve yeni içeriğin dizine ekleneceğini garanti etmez. "Bir şeyi düzelttim, lütfen yeniden bakın" için tasarlanmıştır, "lütfen bu sayfayı keşfedin" için değil. İlki olarak ele alındığında zararsızdır. Bir keşif stratejisi olarak ele alındığında ise hiçbir şeye bağlı olmayan bir koldur.
Daha büyük sorun, yeni bir sayfanın Brave'in dizinine girişini gerçekte neyin belirlediğidir ve bunun bir formla hiçbir ilgisi yoktur.
Brave yeni sayfaları gerçekte nasıl bulur: tek değil, iki kapı
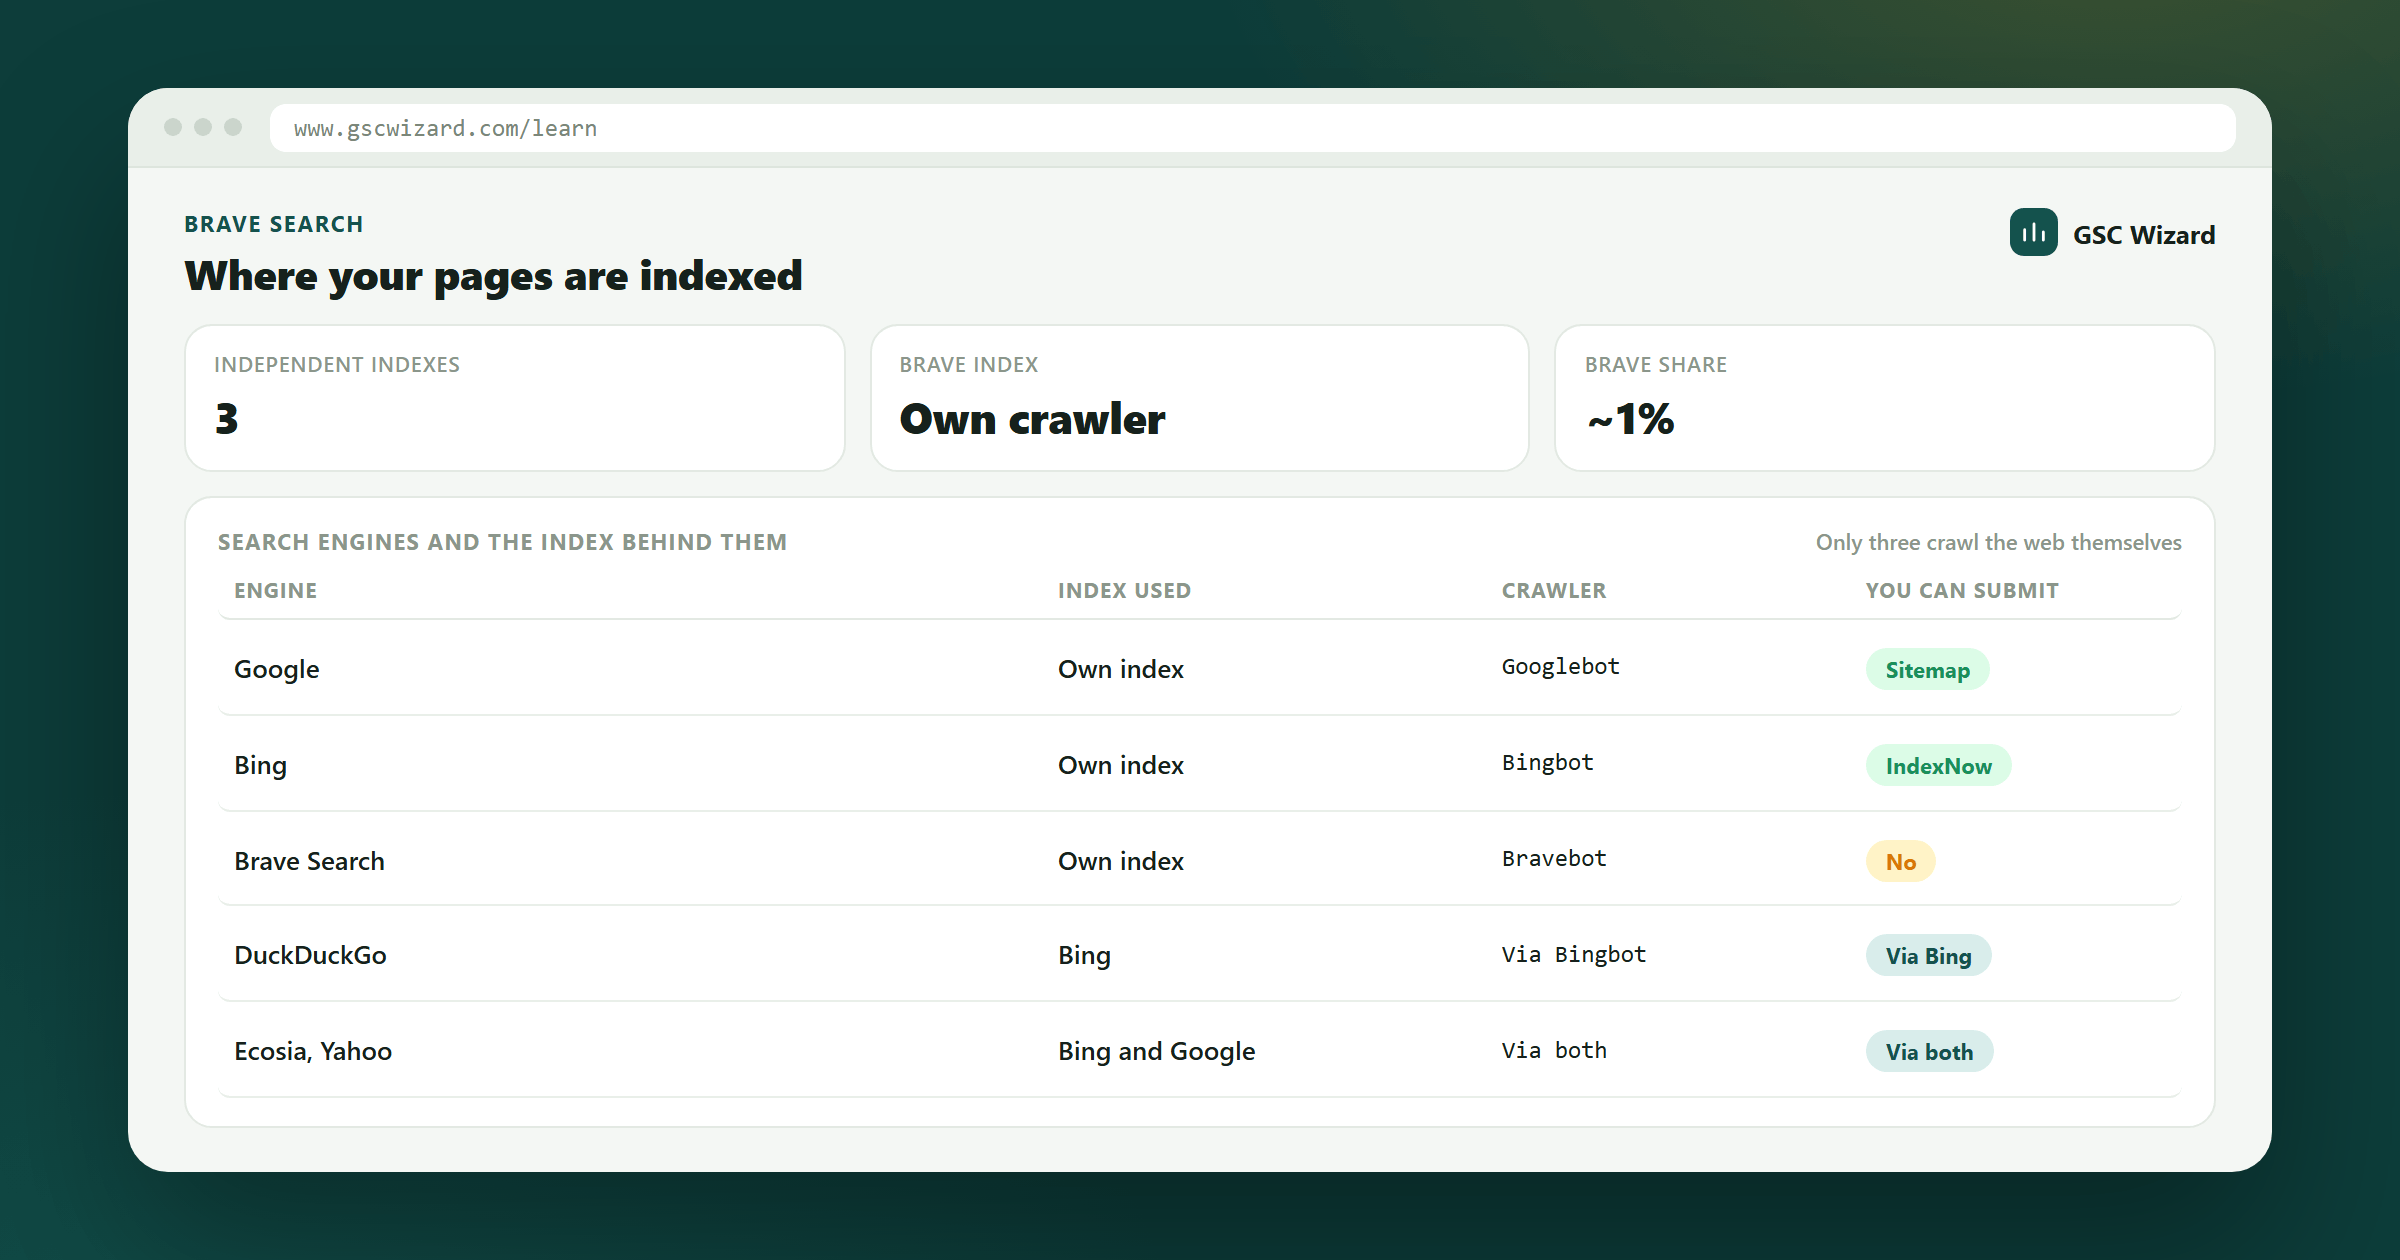
Brave'in bir search console'u, site haritası gönderimi ve IndexNow benzeri bir mekanizması yoktur. Keşif, Web Discovery Project (WDP) üzerinden yürür: Brave tarayıcısında, katılımı kullanıcının tercihine bağlı bir özelliktir ve katılan kullanıcıların hangi sayfalara girdiğini anonim olarak bildirir. Brave'in kendi Yardım Merkezi makalesi bunun kesinlikle isteğe bağlı olduğunu ve katkıda bulunulan verilerin "kimin katkıda bulunduğuyla ilişkilendirilemeyeceğini" doğrular. Bu havuzda yaklaşık 120 milyon kişi olduğu tahmin ediliyor. Hiçbiri sayfanıza ulaşmazsa, yaptığınız başka hiçbir şeyin önemi kalmaz. İçeri girmenin eşikleri çok farklı iki yolu var.
Page Channel: zor kapı
Farklı ağlardan gelen, WDP'ye katılmış yaklaşık 20 farklı kullanıcının sayfaya bağımsız olarak girmesini gerektirir. Sinyaller, Brave'in kendi STAR kriptografik protokolüyle korunur; bu protokol k-anonimlik kullanır, böylece bir değer yalnızca yeterli sayıda bağımsız kullanıcı onu gönderdiğinde okunabilir hale gelir. Brave'in tasarım yazısı mekanizmayı açıklar ancak belirli kota sayısını yayınlamaz; Web Discovery Project'in kendisi için geçen yaklaşık 20 paylaşım rakamı aşağıdaki MERJ'in bağımsız testinden gelir. Her iki durumda da eşiğin altında Brave'in sunucuları sayfanın içeriğini kelimenin tam anlamıyla çözemez veya yeniden oluşturamaz. Bu rastgele bir spam filtresi değil, bir gizlilik mekanizmasıdır, ancak pratik etki aynıdır: gerçek trafiği olmayan yepyeni bir sayfa, Brave için süresiz olarak görünmez kalabilir.
Query Channel: kolay kapı
Yalnızca sayfanızın zaten sıralandığı bir sorguyu Google, Bing, Yahoo veya DuckDuckGo'da arayan tek bir katılımcı kullanıcı gerektirir. Brave'in istemcisi sonuç sayfasını tanır, rastgele 1-20 dakikalık bir gecikmenin ardından sayfanın temizlenmiş bir sürümünü anonim olarak yeniden çeker ve URL'leri ondan alır; 20 kişilik bir kota gerekmez.
Pratik çıkarım: Brave'in dizinine girmenin en hızlı yolu genellikle başka bir yerde zaten sıralanıyor olmaktır. Google, Bing veya DuckDuckGo'da hiç görünürlüğü olmayan bir sayfanın, Brave tarayıcısını kullanan kişilerden gelen organik trafiğe bağlı olan daha zor 20 kişilik eşiği aşması gerekir; bu da toplam kitlenizin "herhangi bir ziyaretçi"den daha küçük bir dilimidir.
Teknik kontrol listesi: Brave'in sayfayı görebildiğinden emin olun
Bir sayfa keşif için uygun hale geldikten sonra bile Brave'in "çift çekme" doğrulamasından geçmesi gerekir: sayfanın herkese aynı göründüğünü doğrulayan, anonim ve oturum açılmamış bir yeniden çekme işlemi. Bu kontrolün kuralları Googlebot'unkinden daha katıdır:
- JavaScript çalıştırılmaz. Yalnızca istemci tarafı oluşturmadan sonra görünen içerik bu kontrol için görünmezdir. Bir sayfa ana içeriği için JS'ye bağımlıysa, onu sunucu tarafında veya önceden oluşturun.
- Yönlendirmeler bir sayfayı eler. Zincirdeki herhangi bir yönlendirme sayfayı özel olarak işaretler; Google'ın sorunsuz hoş gördüğü yönlendirme kalıpları bile.
- Katı performans sınırları. Çekme işlemi 10 saniye sonra iptal edilir ve 2MB'ı aşan yanıtları reddeder. Yavaş ilk bayta kadar geçen süre (TTFB) veya şişkin sayfalar, nedenini söyleyen hiçbir rapor olmadan sessizce başarısız olur.
- Yalnızca HTML sinyalleri sayılır.
X-Robots-TagHTTP başlığıyla gönderilen birnoindexokunmaz; yalnızca HTML<head>içindeki<meta name="robots" content="noindex">okunur. Canonical'lar yalnızca bir<link rel="canonical">öğesinden okunur, asla bir başlıktan değil. CMS'niz bunları başlıklar üzerinden ayarlıyorsa, Brave'in doğrulaması niyetinizi hiç yansıtmayan bir sayfaya bakıyor olabilir. - Canonical olmadan sorgu dizeleri risklidir. İkinci bir sorgu parametresi veya yaklaşık 22 karakteri aşan bir sorgu dizesi, temiz bir adrese işaret eden açık bir canonical etiketi yoksa sayfayı özel olarak işaretler.
- Bazı yol kelimeleri riskli görünür.
login,token,checkout,account,adminveyawp-admingibi kelimeler içeren yollara daha şüpheyle yaklaşılır. Bunları canonical pazarlama URL'lerinin dışında tutun.
robots.txt'in Bravebot'u sessizce engellemesine izin vermeyin
Brave'in kendi Search Crawler yardım sayfası bunu doğrudan doğrular: "Brave Search tarayıcısı ayırt edici bir kullanıcı aracısı (user agent) bildirmez, çünkü yalnızca Google'ın taramasına izin veren web sitelerinden gelecek ayrımcılığı önlemek zorundayız" ve "bir alan adı veya sayfa Googlebot tarafından taranamıyorsa, Brave Search'ün botu da onu taramaz." Pratikte bu, yaygın bir güvenlik kalıbının (robots.txt'te "açıkça tanımadığımız her botu engelle" veya yalnızca adı belirtilen tarayıcılara izin veren bir WAF/CDN kuralı) durdurmak istediği her kazıyıcıyla birlikte Brave'i de sessizce dışarıda bırakabileceği anlamına gelir. Hata mesajı yoktur; sayfa basitçe hiç çekilmez. Bir keşif veya sıralama sorununun içerik kalitesiyle ilgili olduğunu varsaymadan önce, robots.txt dosyanızda her şeyi kapsayan bir Disallow olup olmadığına ve sunucu veya CDN düzeyindeki bot kurallarına bakın (Cloudflare ve benzeri WAF'lar sık rastlanan suçlulardır).
İstikrarı değil, oynaklığı bekleyin
Brave'in dizini Google'ınkinden çok daha küçüktür ve yakın tarihli sinyallere büyük ağırlık veriyor gibi görünür. Brave'in kendisi de altta yatan veriyi hiçbir kullanıcıyla, cihazla veya oturumla ilişkilendirilemez olarak tanımlar ki bu, istikrardan farklı bir tasarım hedefidir. Pratikte Brave'i yakından izleyen birkaç SEO uzmanı tanınabilir bir kalıp bildiriyor: bir sayfa fark ediliyor, birkaç hafta iyi sıralanıyor, sonra aynı hızla düşüyor ve bazen daha sonra geri dönüyor. Brave bunun tam mekaniğini yayınlamadı, bu yüzden bunu belgelenmiş değil, gözlemlenmiş bir kalıp olarak değerlendirin; ancak daha küçük ve tazeliğe ağırlık veren bir dizinin davranış biçimiyle tutarlıdır. Bir Brave sıralama dalgalanmasına, bir Google çekirdek güncellemesine verdiğiniz tepkiyi vermeyin. Oradaki kazançları, gerçek trafiğin üzerine bir bonus olarak görün; haftadan haftaya savunulacak bir metrik olarak değil.
Brave tarayıcısını kendiniz kullanmalı mısınız?
Düşünmeye değer, mütevazı ve gerçekten düşük maliyetli bir taktik, ancak tam zamanlı bir strateji değil. Brave'i indirip Web Discovery Project'e katılmak, dizinin oluşturulmasına yardımcı olan anonim gezinme ve arama sinyalleri gönderir. Katılmışken yayınladığınız kendi sayfalarınızı ziyaret etmek, yeni bir sayfanın ihtiyaç duyduğu 20'ye kadar sinyalden biri olabilir veya sayfanın başka bir yerde zaten sıralandığı bir sorguyu aradığınızda Query Channel'ı tetikleyen tek sinyal olabilir. Tek başına işleri değiştirmez ve gerçek ziyaretçilerin yerini tutmaz, ama bunu yapmanın gerçek bir sakıncası da yoktur.
Bunun Claude'un sizi alıntılayıp alıntılamayacağını da neden belirlediği
Anthropic bu ilişkiyi bir ürün duyurusunda doğrulamadı, ancak kendi Trust Center alt işleyici açıklamaları Brave Search'ü adıyla anıyor ve iki bağımsız çalışma da bunu destekliyor. Profound'un özgün analizi (Mart 2025), Claude'un alıntıları ile Brave'in en iyi sonuçları arasında %86,7'lik bir örtüşme buldu; bu istatistiksel olarak tesadüfün çok ötesinde (p < 0,0001). 400 sorgu üzerinden yaklaşık 35.000 Claude alıntısını kapsayan daha büyük bir MERJ çalışması (Temmuz 2026), Claude'un alıntıladığı URL'lerin eşleşen sorgu için %79,2'sinin Brave'in ilk 10'unda yer aldığı, buna karşılık Google'ın ilk 10'unda yalnızca %34'ünün yer aldığı neredeyse aynı bir sonuca ulaştı. Search Engine Land haberi ise Claude'un Brave'in sonuçlarını yeniden sıralamadığını, bunları neredeyse olduğu gibi kullandığını ekliyor.
Pratikte bu, yukarıdaki her şeyin (Brave tarafından taranabilir olmak, çift çekmeye uygun olmak, gerçekten dizine eklenmek ve sıralanmak) yalnızca Google'ı hedefleyen herhangi bir şeyden Claude görünürlüğü için daha doğrudan bir kaldıraç olduğu anlamına gelir. Yalnızca Google için optimize ederseniz, iki örtüşmenin küçüğü için optimize etmiş olursunuz.
Kontrol listesi
- Bravebot'u sessizce dışarıda bırakıyor olabilecek, her şeyi kapsayan bir engel için robots.txt dosyasını ve tüm WAF/bot kurallarını denetleyin.
- Ana içeriğin sunucu tarafında oluşturulduğunu doğrulayın (yalnızca JS ile değil), yönlendirme zincirlerinden kaçının ve sayfaları 10 saniye / 2MB çift çekme sınırlarının oldukça altında tutun.
- Yalnızca bir başlık değil, gerçek bir
<link rel="canonical">etiketi kullanın ve canonical URL'leri gereksiz sorgu parametrelerinden arındırılmış tutun. - Google, Bing veya DuckDuckGo'da gerçek sıralama görünürlüğü oluşturun veya doğrulayın. Brave'e açılan hızlı Query Channel kapısı budur.
- Dayanabileceğiniz mevcut bir sıralama yoksa, Brave tarayıcısı kullanıcılarına ulaşabilecek gerçek tanıtıma odaklanın: gerçek bir kitle oluşturma çalışması, gönderim formları değil.
- Submit URL'yi yalnızca gerçek bir düzeltmeden sonra kullanın, yeniden bakılmasını sağlamak için. Bir keşif mekanizması olarak değil.
- Brave'deki kısa vadeli sıralama dalgalanmalarında paniğe kapılmayın. Haftadan haftaya değişen gürültüyü değil, kalıcı görünürlüğü sinyal olarak kabul edin.
- İsterseniz Brave'i Web Discovery Project etkinken kendiniz de kullanın. Maliyeti düşüktür ve sizi kendi sinyallerinizden biri haline getirir.
Sonraki rehber
GSC Wizard Brave'i takip etmez (henüz hiçbir üçüncü taraf konsolu etmiyor), ancak Bravebot'u sessizce engelleyen taranabilirlik sorunları çoğu zaman gerçek kullanıcıları ve diğer botları da etkiler. Kendi sitenizde teknik dizine ekleme sorunlarını teşhis ederek → başlayın; bu rehber yalnızca Google için değil, her arama motoru için önemli olan robots.txt ve canonical sorunlarını kapsar.
Yazan: Jan-Willem Bobbink · Yayın tarihi: 28 Ağustos 2026